<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom" xml:lang="fr">
  <title>Data Bene - Tag: 'BDD Graphes'</title>
  <subtitle>Base de données relationnelles, open-source et adaptives.</subtitle>
  <link href="https://www.data-bene.io/fr/blog/tag/bdd-graphes/feed.xml" rel="self" type="application/atom+xml" />
  <updated>2026-10-21T00:00:00Z</updated>
  <id>https://www.data-bene.io/fr/blog/tag/bdd-graphes/feed.xml</id>
    <entry>
      <title>PostgreSQL comme base de données graphique, partie 1: SQL/PGQ dans PostgreSQL</title>
      <link href="https://www.data-bene.io/fr/blog/postgresql-comme-bdd-graphe-part-1/" />
      <updated>2026-10-21T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/postgresql-comme-bdd-graphe-part-1/</id>
     <content type="html"><![CDATA[ <p><em>Cet article est le deuxième d’une série consacrée aux bases de données graphiques et à PostgreSQL. <a href="/fr/blog/postgresql-comme-bdd-graphe/">Le premier</a> a posé les bases: qu’est-ce qu’un graphe, ce qu’on peut modéliser comme graphe, et le paysage des systèmes graphiques. Celui-ci passe du général au spécifique: comment on interroge les graphes, pourquoi SQL peut être maladroit pour cela, et ce que SQL/PGQ change. Il s’achève sur l’implémentation PostgreSQL, les raisons de son annulation, et quelques notes sur les fonctionnalités principales encore à venir.</em></p>
<h2 id="les-langages-dinterrogation-des-graphes"><a class="heading-anchor" href="#les-langages-dinterrogation-des-graphes">Les langages d’interrogation des graphes</a></h2>
<p>Dans <a href="/fr/blog/postgresql-comme-bdd-graphe/">l’article précédent</a>, nous avons terminé par l’observation que les bases de données graphiques existent sous de nombreuses formes, qu’elles diffèrent dans leur façon de stocker les graphes et les modèles de données supportés. Elles diffèrent aussi sur la manière de les interroger.</p>
<p>Contrairement au monde relationnel, qui s’est convergé précocement vers SQL et l’a conservé comme standard dominant pendant des décennies, l’écosystème des graphes a engendré une prolifération de langages:</p>
<ul class="list">
<li>Cypher<sup class="footnote-ref"><a href="#fn1" id="fnref1">[1]</a></sup>, créé chez Neo4j, représente les motifs en ASCII art:<br>
<code>(a:Person)-[:KNOWS]-&gt;(b:Person)</code> ;</li>
<li>Gremlin<sup class="footnote-ref"><a href="#fn2" id="fnref2">[2]</a></sup>, issu d’Apache TinkerPop, est impératif et basé sur des étapes:<br>
<code>g.V().hasLabel('Person').out('KNOWS')</code> ;</li>
<li>PGQL<sup class="footnote-ref"><a href="#fn3" id="fnref3">[3]</a></sup>, d’Oracle, intègre les motifs de graphe dans une enveloppe de type SQL ;</li>
<li>Et en 2024, GQL<sup class="footnote-ref"><a href="#fn4" id="fnref4">[4]</a></sup> a été ratifié comme norme ISO/IEC 39075, le premier nouveau langage de requête de base de données à atteindre une standardisation ISO depuis SQL lui-même.</li>
</ul>
<p>Pour cette série, le plus pertinent est SQL/PGQ<sup class="footnote-ref"><a href="#fn5" id="fnref5">[5]</a></sup>, <strong>standardisé dans SQL:2023</strong>. C’est une extension de SQL qui permet de définir des graphes à propriétés sur des tables existantes et de les interroger avec une syntaxe de motifs de type GQL/PGQL intégrée dans un <code>SELECT</code> standard.</p>
<h2 id="a-quel-point-sql-est-il-bon-pour-les-graphes"><a class="heading-anchor" href="#a-quel-point-sql-est-il-bon-pour-les-graphes">À quel point SQL est-il bon pour les graphes ?</a></h2>
<p>Prenons un réseau social stocké dans deux tables: <code>person</code> et <code>knows</code>.<br>
Une requête Cypher qui cherche les amis d’amis ressemble à:</p>
<pre class="language-cypher"><code class="language-cypher"> <span class="token keyword">MATCH</span> <span class="token punctuation">(</span>a<span class="token operator">:</span><span class="token class-name">Person</span><span class="token punctuation">)</span><span class="token operator">-</span><span class="token punctuation">[</span><span class="token operator">:</span><span class="token relationship property">KNOWS</span><span class="token punctuation">]</span><span class="token operator">-></span><span class="token punctuation">(</span>b<span class="token punctuation">)</span><span class="token operator">-</span><span class="token punctuation">[</span><span class="token operator">:</span><span class="token relationship property">KNOWS</span><span class="token punctuation">]</span><span class="token operator">-></span><span class="token punctuation">(</span>c<span class="token punctuation">)</span>
 <span class="token keyword">WHERE</span> a<span class="token punctuation">.</span>name <span class="token operator">=</span> <span class="token string">'Alice'</span>
<span class="token keyword">RETURN</span> c<span class="token punctuation">.</span>name</code></pre>
<p>L’équivalent en SQL pur est une double jointure croisée:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">SELECT</span> <span class="token keyword">DISTINCT</span> c<span class="token punctuation">.</span>name
  <span class="token keyword">FROM</span> person a
  <span class="token keyword">JOIN</span> knows k1 <span class="token keyword">ON</span> k1<span class="token punctuation">.</span>src <span class="token operator">=</span> a<span class="token punctuation">.</span>id
  <span class="token keyword">JOIN</span> person b <span class="token keyword">ON</span> k1<span class="token punctuation">.</span>dst <span class="token operator">=</span> b<span class="token punctuation">.</span>id
  <span class="token keyword">JOIN</span> knows k2 <span class="token keyword">ON</span> k2<span class="token punctuation">.</span>src <span class="token operator">=</span> b<span class="token punctuation">.</span>id
  <span class="token keyword">JOIN</span> person c <span class="token keyword">ON</span> k2<span class="token punctuation">.</span>dst <span class="token operator">=</span> c<span class="token punctuation">.</span>id
 <span class="token keyword">WHERE</span> a<span class="token punctuation">.</span>name <span class="token operator">=</span> <span class="token string">'Alice'</span><span class="token punctuation">;</span></code></pre>
<p>Ce n’est pas mal. C’est verbeux, mais c’est expressible, le JOIN est explicite, et que ce soient deux sauts ou dix, chaque saut est conciste à écrire d’avantage de JOINs.</p>
<p>Essayons quelque chose de plus centré sur les graphes maintenant. Supposons que nous voulons toutes les personnes atteignables depuis Alice en cinq sauts <code>KNOWS</code>. En SQL/PGQ (très similaire à Cypher), c’est un seul motif:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">SELECT</span> c<span class="token punctuation">.</span>name
  <span class="token keyword">FROM</span> GRAPH_TABLE<span class="token punctuation">(</span>
          social_graph
    <span class="token keyword">MATCH</span> <span class="token punctuation">(</span>a <span class="token operator">IS</span> Person <span class="token keyword">WHERE</span> a<span class="token punctuation">.</span>name <span class="token operator">=</span> <span class="token string">'Alice'</span><span class="token punctuation">)</span><span class="token operator">-</span><span class="token punctuation">[</span><span class="token operator">IS</span> KNOWS<span class="token punctuation">]</span><span class="token operator">-</span><span class="token operator">></span>{<span class="token number">1</span><span class="token punctuation">,</span><span class="token number">5</span>}<span class="token punctuation">(</span>c <span class="token operator">IS</span> Person<span class="token punctuation">)</span>
  <span class="token keyword">COLUMNS</span> <span class="token punctuation">(</span>c<span class="token punctuation">.</span>name<span class="token punctuation">)</span>
<span class="token punctuation">)</span> <span class="token keyword">AS</span> g<span class="token punctuation">;</span></code></pre>
<p>En SQL, cela devient un peu lourd:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">WITH</span> RECURSIVE reachable<span class="token punctuation">(</span>id<span class="token punctuation">,</span> depth<span class="token punctuation">,</span> path<span class="token punctuation">)</span> <span class="token keyword">AS</span> <span class="token punctuation">(</span>
    <span class="token keyword">SELECT</span> p<span class="token punctuation">.</span>id
         <span class="token punctuation">,</span> <span class="token number">0</span>
         <span class="token punctuation">,</span> ARRAY<span class="token punctuation">[</span>p<span class="token punctuation">.</span>id<span class="token punctuation">]</span>
      <span class="token keyword">FROM</span> person p
     <span class="token keyword">WHERE</span> p<span class="token punctuation">.</span>name <span class="token operator">=</span> <span class="token string">'Alice'</span>
    <span class="token keyword">UNION</span> <span class="token keyword">ALL</span>
    <span class="token keyword">SELECT</span> k<span class="token punctuation">.</span>dst
         <span class="token punctuation">,</span> r<span class="token punctuation">.</span>depth <span class="token operator">+</span> <span class="token number">1</span>
         <span class="token punctuation">,</span> r<span class="token punctuation">.</span>path <span class="token operator">||</span> k<span class="token punctuation">.</span>dst
      <span class="token keyword">FROM</span> reachable r
      <span class="token keyword">JOIN</span> knows k <span class="token keyword">ON</span> k<span class="token punctuation">.</span>src <span class="token operator">=</span> r<span class="token punctuation">.</span>id
     <span class="token keyword">WHERE</span> r<span class="token punctuation">.</span>depth <span class="token operator">&lt;</span> <span class="token number">5</span>
       <span class="token operator">AND</span> k<span class="token punctuation">.</span>dst <span class="token operator">&lt;></span> <span class="token keyword">ALL</span><span class="token punctuation">(</span>r<span class="token punctuation">.</span>path<span class="token punctuation">)</span>
<span class="token punctuation">)</span>
<span class="token keyword">SELECT</span> <span class="token keyword">DISTINCT</span> p<span class="token punctuation">.</span>name
  <span class="token keyword">FROM</span> reachable r
  <span class="token keyword">JOIN</span> person p <span class="token keyword">ON</span> p<span class="token punctuation">.</span>id <span class="token operator">=</span> r<span class="token punctuation">.</span>id
 <span class="token keyword">WHERE</span> r<span class="token punctuation">.</span>depth <span class="token operator">></span> <span class="token number">0</span><span class="token punctuation">;</span></code></pre>
<p>L’auteur encode désormais la limite de profondeur, transporte le chemin dans un tableau pour éviter les cycles, et retire la ligne racine à la fin. PostgreSQL 14 a ajouté les clauses <code>SEARCH</code> et <code>CYCLE</code><sup class="footnote-ref"><a href="#fn6" id="fnref6">[6]</a></sup> qui masquent une partie de cette gestion administrative, mais la requête reste un calcul de point fixe récursif qui arrive à produire le bon résultat.</p>
<p>Bien que ce soit un parcours de graphe basique, les choses deviennent encore plus complexes. Pour les plus courts chemins, il faudrait suivre la distance et faire du “pruning”. Si on demande un tracé (pas de répétition d’arêtes), il faudrait suivre les arêtes, pas seulement les sommets.</p>
<h2 id="definir-et-interroger-un-graphe-en-sql/pgq"><a class="heading-anchor" href="#definir-et-interroger-un-graphe-en-sql/pgq">Définir et interroger un graphe en SQL/PGQ</a></h2>
<p>À partir d’ici, nous utilisons un exemple plus riche, situé dans la galaxie Star Wars. Les Jedi combattaient sur des planètes, et les Sith sur des stations. Les tables de sommets sont <code>jedi</code>, <code>sith</code>, <code>planet</code> et <code>station</code>, chacune avec un <code>id</code> et un <code>name</code>, plus un <code>title</code> pour les combattants et une <code>region</code> pour les lieux. Deux tables d’arêtes, <code>fought_on_planet</code> et <code>fought_on_station</code>, contiennent chacune un identifiant source, un identifiant destination, et le nom de la bataille.</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> jedi <span class="token punctuation">(</span>
    id     <span class="token keyword">BIGINT</span> <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span><span class="token punctuation">,</span>
    name   <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    title  <span class="token keyword">TEXT</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> sith <span class="token punctuation">(</span>
    id     <span class="token keyword">BIGINT</span> <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span><span class="token punctuation">,</span>
    name   <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    title  <span class="token keyword">TEXT</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> planet <span class="token punctuation">(</span>
    id      <span class="token keyword">BIGINT</span> <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span><span class="token punctuation">,</span>
    name    <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    region  <span class="token keyword">TEXT</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> station <span class="token punctuation">(</span>
    id      <span class="token keyword">BIGINT</span> <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span><span class="token punctuation">,</span>
    name    <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    region  <span class="token keyword">TEXT</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> fought_on_planet <span class="token punctuation">(</span>
    a       <span class="token keyword">BIGINT</span> <span class="token keyword">REFERENCES</span> jedi <span class="token punctuation">(</span>id<span class="token punctuation">)</span><span class="token punctuation">,</span>
    b       <span class="token keyword">BIGINT</span> <span class="token keyword">REFERENCES</span> planet <span class="token punctuation">(</span>id<span class="token punctuation">)</span><span class="token punctuation">,</span>
    battle  <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span> <span class="token punctuation">(</span>a<span class="token punctuation">,</span> b<span class="token punctuation">)</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> fought_on_station <span class="token punctuation">(</span>
    a       <span class="token keyword">BIGINT</span> <span class="token keyword">REFERENCES</span> sith <span class="token punctuation">(</span>id<span class="token punctuation">)</span><span class="token punctuation">,</span>
    b       <span class="token keyword">BIGINT</span> <span class="token keyword">REFERENCES</span> station <span class="token punctuation">(</span>id<span class="token punctuation">)</span><span class="token punctuation">,</span>
    battle  <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span> <span class="token punctuation">(</span>a<span class="token punctuation">,</span> b<span class="token punctuation">)</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span></code></pre>
<p>Le graphe est déclaré sur celles-ci:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">CREATE</span> PROPERTY GRAPH galaxy
    VERTEX <span class="token keyword">TABLES</span> <span class="token punctuation">(</span>
        jedi    <span class="token keyword">KEY</span> <span class="token punctuation">(</span>id<span class="token punctuation">)</span> LABEL force_user PROPERTIES <span class="token punctuation">(</span>id<span class="token punctuation">,</span> name<span class="token punctuation">,</span> title<span class="token punctuation">)</span><span class="token punctuation">,</span>
        sith    <span class="token keyword">KEY</span> <span class="token punctuation">(</span>id<span class="token punctuation">)</span> LABEL force_user PROPERTIES <span class="token punctuation">(</span>id<span class="token punctuation">,</span> name<span class="token punctuation">,</span> title<span class="token punctuation">)</span><span class="token punctuation">,</span>
        planet  <span class="token keyword">KEY</span> <span class="token punctuation">(</span>id<span class="token punctuation">)</span> LABEL place      PROPERTIES <span class="token punctuation">(</span>id<span class="token punctuation">,</span> name<span class="token punctuation">,</span> region<span class="token punctuation">)</span><span class="token punctuation">,</span>
        station <span class="token keyword">KEY</span> <span class="token punctuation">(</span>id<span class="token punctuation">)</span> LABEL place      PROPERTIES <span class="token punctuation">(</span>id<span class="token punctuation">,</span> name<span class="token punctuation">,</span> region<span class="token punctuation">)</span>
    <span class="token punctuation">)</span>
    EDGE <span class="token keyword">TABLES</span> <span class="token punctuation">(</span>
        fought_on_planet
            SOURCE <span class="token keyword">KEY</span> <span class="token punctuation">(</span>a<span class="token punctuation">)</span>      <span class="token keyword">REFERENCES</span> jedi <span class="token punctuation">(</span>id<span class="token punctuation">)</span>
            DESTINATION <span class="token keyword">KEY</span> <span class="token punctuation">(</span>b<span class="token punctuation">)</span> <span class="token keyword">REFERENCES</span> planet <span class="token punctuation">(</span>id<span class="token punctuation">)</span>
            LABEL fought_at     PROPERTIES <span class="token punctuation">(</span>battle<span class="token punctuation">)</span><span class="token punctuation">,</span>
        fought_on_station
            SOURCE <span class="token keyword">KEY</span> <span class="token punctuation">(</span>a<span class="token punctuation">)</span>      <span class="token keyword">REFERENCES</span> sith <span class="token punctuation">(</span>id<span class="token punctuation">)</span>
            DESTINATION <span class="token keyword">KEY</span> <span class="token punctuation">(</span>b<span class="token punctuation">)</span> <span class="token keyword">REFERENCES</span> station <span class="token punctuation">(</span>id<span class="token punctuation">)</span>
            LABEL fought_at     PROPERTIES <span class="token punctuation">(</span>battle<span class="token punctuation">)</span>
    <span class="token punctuation">)</span><span class="token punctuation">;</span></code></pre>
<p>Les labels regroupent des tables: <code>force_user</code> couvre deux tables de sommets, <code>place</code> en couvre deux, et <code>fought_at</code> couvre les deux tables d’arêtes. Le graphe ne contient aucune donnée.<br>
Dans PostgreSQL, c’est un nouveau type de relation (<code>RELKIND_PROPGRAPH</code>) qui vit dans <code>pg_class</code> sans “heap” (table) et sans colonne propre, ce qui fait qu’il se comporte comme une vue. Cinq nouveaux catalogues (<code>pg_propgraph_element</code>, <code>pg_propgraph_label</code> et trois autres) enregistrent ses éléments, labels et propriétés.</p>
<p>L’interroger:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">SELECT</span> <span class="token operator">*</span>
<span class="token keyword">FROM</span> GRAPH_TABLE <span class="token punctuation">(</span>
            galaxy
      <span class="token keyword">MATCH</span> <span class="token punctuation">(</span>a <span class="token operator">IS</span> force_user<span class="token punctuation">)</span><span class="token operator">-</span><span class="token punctuation">[</span><span class="token operator">IS</span> fought_at<span class="token punctuation">]</span><span class="token operator">-</span><span class="token operator">></span><span class="token punctuation">(</span>b <span class="token operator">IS</span> place<span class="token punctuation">)</span>
    <span class="token keyword">COLUMNS</span> <span class="token punctuation">(</span>a<span class="token punctuation">.</span>name <span class="token keyword">AS</span> fighter<span class="token punctuation">,</span> b<span class="token punctuation">.</span>name <span class="token keyword">AS</span> battlefield<span class="token punctuation">,</span> b<span class="token punctuation">.</span>region<span class="token punctuation">)</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span></code></pre>
<h3 id="comment-fonctionne-la-reecriture"><a class="heading-anchor" href="#comment-fonctionne-la-reecriture">Comment fonctionne la réécriture ?</a></h3>
<p>PostgreSQL n’a pas de nouveau nœud “exécuteur”. L’analyseur transforme <code>GRAPH_TABLE</code> en un nouveau type de “range-table”, <code>RTE_GRAPH_TABLE</code>. La réécriture, le même stade qui étend les vues, la remplace ensuite par une sous-requête ordinaire.<br>
Il procède en quatre étapes:</p>
<ol class="list">
<li>Le motif est lu de gauche à droite dans une liste de motifs d’éléments: sommets, arêtes dans les deux sens, et sous-motifs imbriqués.</li>
<li>Chaque nom de variable unique devient un facteur de chemin. Une variable qui apparaît deux fois, dans un cycle qui retourne à <code>a</code>, partage un même facteur, et ses prédicats sont conjoints par <code>AND</code>.</li>
<li>Chaque expression de label est résolue vers les tables qu’elle couvre, donnant un élément de chemin par table.</li>
<li>Chaque combinaison d’éléments le long du chemin est énumérée par un DFS (recherche en profondeur d’abord) récursif. Une combinaison n’est valide que si les clés source et destination de chaque table d’arêtes relient vraiment les deux tables de sommets voisines. Chaque combinaison valide devient un <code>JOIN</code> entre les tables d’arêtes et de sommets sur ces clés, et toutes sont combinées par <code>UNION ALL</code>.</li>
</ol>
<p>Dans notre requête, <code>force_user</code> a deux tables, <code>fought_at</code> en a deux, et <code>place</code> en a deux, il y a donc 2 × 2 × 2 = 8 combinaisons. Seulement deux sont valides: un Jedi sur une planète, et un Sith dans une station. La requête devient équivalente à:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">SELECT</span> jedi<span class="token punctuation">.</span>name<span class="token punctuation">,</span> planet<span class="token punctuation">.</span>name<span class="token punctuation">,</span> planet<span class="token punctuation">.</span>region
  <span class="token keyword">FROM</span> jedi<span class="token punctuation">,</span> fought_on_planet<span class="token punctuation">,</span> planet
 <span class="token keyword">WHERE</span> jedi<span class="token punctuation">.</span>id <span class="token operator">=</span> fought_on_planet<span class="token punctuation">.</span>a
   <span class="token operator">AND</span> planet<span class="token punctuation">.</span>id <span class="token operator">=</span> fought_on_planet<span class="token punctuation">.</span>b
<span class="token keyword">UNION</span> <span class="token keyword">ALL</span>
<span class="token keyword">SELECT</span> sith<span class="token punctuation">.</span>name<span class="token punctuation">,</span> station<span class="token punctuation">.</span>name<span class="token punctuation">,</span> station<span class="token punctuation">.</span>region
  <span class="token keyword">FROM</span> sith<span class="token punctuation">,</span> fought_on_station<span class="token punctuation">,</span> station
 <span class="token keyword">WHERE</span> sith<span class="token punctuation">.</span>id <span class="token operator">=</span> fought_on_station<span class="token punctuation">.</span>a
   <span class="token operator">AND</span> station<span class="token punctuation">.</span>id <span class="token operator">=</span> fought_on_station<span class="token punctuation">.</span>b<span class="token punctuation">;</span></code></pre>
<p>À partir de ce point, le planificateur et l’exécuteur voient des jointures et une union, rien de spécifique aux graphes. Ceci a une certaine valeur car nous bénéficions des index, des statistiques, de l’interrogation parallèle et de tout ce que PostgreSQL possède — ce qui rappelle l’argument que nous faisons dans le <a href="/fr/blog/postgresql-comme-bdd-graphe/">précédent article</a> de la série sur les bases de données graphes construites sur des systèmes matures.</p>
<p><strong>Il y a ici une subtilité qui compte pour la lecture de tout benchmark comparant les deux formalismes.</strong></p>
<p>Dans un motif de longueur fixe, SQL/PGQ est obligé de toucher les tables de sommets. Le motif lie les sommets, donc la jointure vers la table de sommets fait partie de la sémantique même lorsqu’aucune propriété de sommet n’est demandée, car il n’y a pas de clés étrangères (FK). Si vous modélisiez le même graphe vous-même en SQL pur et aviez seulement besoin de la traversée des arêtes, à condition d’avoir défini des FK, joindre les tables d’arêtes seules suffit.</p>
<p><em>Note: il y a un effort récent, non validé, de la part de hackers PostgreSQL pour éliminer les inner joins basés sur les clés étrangères, ce qui serait bénéfique pour la réécriture SQL/PGQ + FK sur les tables élémentaires du graphe<sup class="footnote-ref"><a href="#fn7" id="fnref7">[7]</a></sup>.</em></p>
<h3 id="ce-qui-est-supporte-et-ce-qui-ne-lest-pas"><a class="heading-anchor" href="#ce-qui-est-supporte-et-ce-qui-ne-lest-pas">Ce qui est supporté et ce qui ne l’est pas</a></h3>
<p>La norme recense 100 fonctionnalités. L’implémentation validée en couvrait 26. Elle supporte les motifs graphiques avec <code>WHERE</code>, les motifs de sommets, les motifs d’arêtes sous forme complète et abrégée, la disjonction de labels (<code>label1|label2</code>), les références de propriétés, <code>GRAPH_TABLE</code>, le DDL incluant <code>ALTER</code> et <code>DROP</code>, plusieurs labels par table élémentaire, et les vues comme tables élémentaires.</p>
<p>Les plus intéressantes des 74 manquantes relèvent (pour la plupart) de cinq mécanismes que la norme définit au-dessus d’un motif de base:</p>
<table>
<thead>
<tr>
<th>Mécanisme</th>
<th>Ce qu’il décide</th>
<th>PostgreSQL</th>
</tr>
</thead>
<tbody>
<tr>
<td>Quantificateurs: <code>{n,m}</code>, <code>{n}</code>, <code>+</code>, <code>*</code></td>
<td>Le nombre de sauts couverts par un motif</td>
<td>Non supporté</td>
</tr>
<tr>
<td></td>
<td></td>
<td></td>
</tr>
<tr>
<td>Modes de chemin: <code>WALK</code>, <code>TRAIL</code>, <code>SIMPLE</code>, <code>ACYCLIC</code></td>
<td>Quels chemins sont admissibles (quoi qui peut se répéter)</td>
<td>Comporte comme <code>WALK</code>, mots-clés rejetés</td>
</tr>
<tr>
<td></td>
<td></td>
<td></td>
</tr>
<tr>
<td>Préfixes de recherche de chemin: <code>ALL</code>, <code>ANY</code>, <code>ALL SHORTEST</code>, <code>SHORTEST n</code></td>
<td>Quels chemins admissibles sont retournés</td>
<td>Seulement <code>ALL</code>, le défaut</td>
</tr>
<tr>
<td></td>
<td></td>
<td></td>
</tr>
<tr>
<td>Modes de correspondance: <code>REPEATABLE ELEMENTS</code>, <code>DIFFERENT EDGES</code></td>
<td>Si les arêtes peuvent se lier deux fois</td>
<td>Seulement <code>REPEATABLE ELEMENTS</code></td>
</tr>
<tr>
<td></td>
<td></td>
<td></td>
</tr>
<tr>
<td>Plusieurs motifs de chemin séparés par des virgules dans un <code>MATCH</code></td>
<td>Jointure de motifs sur des variables partagées</td>
<td>Patch existant, retardé après les quantificateurs</td>
</tr>
</tbody>
</table>
<p>PostgreSQL n’est pas seul ici. Le SQL/PGQ d’Oracle est tout aussi réduit, DuckPGQ n’ajoute que <code>ANY SHORTEST</code>, et l’ancien PGQL d’Oracle supporte la plupart de ces fonctionnalités.</p>
<h3 id="lannulation-git-revert"><a class="heading-anchor" href="#lannulation-git-revert">L’annulation (“git revert”)</a></h3>
<p>SQL/PGQ a été validé le 16 mars 2026 pour PostgreSQL 19. Début septembre, une discussion sur <code>pgsql-hackers</code> concernant certains problèmes dans sa représentation/catalogue et ses dépendances d’objets s’est achevé par une décision de le retirer.<br>
Les reviewers ont estimé qu’il devait être retiré de cette version afin que les problèmes puissent être corrigés proprement pour 20, sans la pression de la compatibilité ascendante.</p>
<p>La fonctionnalité devrait revenir dans une version future. La réécriture elle-même n’est pas la partie en cours de refonte, elle devrait donc survivre, inchangée, ce qui signifie que le travail supplémentaire — VLE (variable length edge), motifs multi-chemins, etc. — pourra s’appuyer sur le même socle.</p>
<p>Il est d’ailleurs à noter que tout cela n’a pas à être nécessairement dans le noyau. PostgreSQL n’a pas de parser hook, donc une extension ne peut pas ajouter de grammaire, et les parser hooks ont été proposés et discutés à maintes reprises sans aboutir. La dernière mention concernait la manière de publier SQL/PGQ comme fonctionnalité expérimentale<sup class="footnote-ref"><a href="#fn8" id="fnref8">[8]</a></sup>.<br>
Il ne reste à SQL/PGQ que deux options: travailler dans le noyau, ou faire ce que fait Apache AGE et parser une chaîne à l’exécution ; bien sûr, la deuxième est un élément pour une extension, pas pour une fonctionnalité du noyau.<br>
<strong>Si les extensions avaient pu étendre le parseur, cela aurait pu être construit et prouvé hors de l’arbre, puis ensuite considéré pour un module contrib ou pour le noyau. Ce n’est pas un argument en faveur des parser hooks. C’est une observation sur là où le coût de ne pas les avoir finit par peser.</strong></p>
<h3 id="la-fonctionnalite-que-tout-le-monde-reclame"><a class="heading-anchor" href="#la-fonctionnalite-que-tout-le-monde-reclame">La fonctionnalité que tout le monde réclame</a></h3>
<p>Des morceaux manquants, l’un domine chaque conversation sur les requêtes de graphe: <strong>les arêtes de longueur variable</strong> (VLE).<br>
C’est la fonctionnalité que les utilisatrices et utilisateurs de graphes réclament en premier, et c’est souvent la raison pour laquelle on se tourne vers un langage de requête de graphe plutôt que d’écrire des jointures. La difficulté est proportionnelle à l’échelle. Un motif borné sur deux ou trois sauts peut être fait avec une réécriture similaire vers des jointures. Un motif pouvant atteindre des centaines de sauts, ou s’exécuter de manière non bornée jusqu’à épuisement du graphe, est un problème différent avec ses propres exigences de mémoire, de terminaison et de gestion des cycles.</p>
<p>La norme rend cela plus difficile qu’il n’y paraît, car elle définit plusieurs mécanismes et fonctionnalités qui interagissent avec elle. Comment le motif s’étend, quels chemins comptent comme admissibles, et lesquels de ceux-ci sont retournés sont décidés indépendamment, et chaque combinaison implique une stratégie d’exécution différente. Tous les chemins sur une profondeur bornée, un seul chemin le plus court, et les extrémités atteignables distinctes sont des motifs différents dont il faut tenir compte dans la conception. Bien sûr, on NE peut PAS tout supporter, mais il est important de garder ces sémantiques en tête.</p>
<p>Les implémentations varient. Une approche est une nouvelle réécriture, cette fois vers des CTE récursifs, s’appuyant sur les clauses <code>SEARCH</code> et <code>CYCLE</code> et faisant beaucoup de gestion administrative directement dans la requête pour les différentes sémantiques. En bout de ligne, c’est un BFS (recherche en largeur) basé sur des ensembles exprimé sous forme de jointures ; c’est acceptable mais ce ne sera ni performant ni flexible à combiner avec d’autres fonctionnalités comme les variables de chemin.</p>
<p>Une autre approche étend chaque longueur possible dans son propre <code>UNION ALL</code>, ce qui ne peut pas gérer le cas non borné. C’est une très mauvaise idée ; Oracle fait ça. Puis il y a les stratégies au niveau de l’exécuteur: DFS avec état de chemin pour le backtracking, ou BFS exécuté directement dans l’exécuteur (tous avec de nouveaux nœuds exécuteur). Chacune est adaptée à un objectif différent, qu’il s’agisse d’accessibilité, de plus court chemin, ou d’énumération de tous les chemins possibles. L’implémentation future prendra en compte toutes celles-ci, <strong>autrement on ne peut pas considérer Postgres dans la course, en aucune manière.</strong></p>
<h2 id="points-cles"><a class="heading-anchor" href="#points-cles">Points clés</a></h2>
<p>SQL/PGQ réécrit les motifs de graphe en jointures — pas de nouveaux nœuds exécuteur, pas de moteur de graphe. Le planificateur gère le reste avec les index, les statistiques et l’interrogation parallèle.</p>
<p>L’implémentation validée couvrait 26 des 100 fonctionnalités de la norme, de quoi prouver l’approche mais en s’arrêtant avant les problèmes difficiles. Les quantificateurs, les modes de chemin et les arêtes de longueur variable étaient intentionnellement différés.</p>
<p>L’annulation est lié au “timing”. Les catalogues et le suivi des dépendances nécessitent une base plus propre pour PostgreSQL 20. Le moteur de réécriture lui-même n’est pas en cours de refonte.</p>
<p>La gestion des arêtes de longueur variable est la fonctionnalité requise. La norme définit plusieurs mécanismes au-dessus du VLE qui impliquent différentes stratégies d’exécution — BFS basé sur des ensembles via des CTE récursives, bras <code>UNION ALL</code> par longueur, ou DFS/BFS au niveau de l’exécuteur avec de nouveaux nœuds. Chacune sert un objectif différent.</p>
<p>Sans parser hooks, SQL/PGQ doit vivre dans le noyau ou utiliser un analyseur de chaîne à l’exécution.</p>
<h2 id="et-maintenant"><a class="heading-anchor" href="#et-maintenant">Et maintenant ?</a></h2>
<p>Le prochain article examine les autres options de graphes dans PostgreSQL: Apache AGE, pgRouting, et le cas pratique pour ou contre chacune.<br>
Ensuite, un benchmark comparant SQL/PGQ à Apache AGE.<br>
Et enfin, à quoi ressemble la vision à long terme pour les requêtes de graphe dans PostgreSQL, et pourquoi la trajectoire pointe vers l’absorption des charges de travail des graphes dans les systèmes relationnels.</p>
<hr class="footnotes-sep">
<section class="footnotes">
<ol class="footnotes-list">
<li id="fn1" class="footnote-item"><p><a href="https://neo4j.com/docs/getting-started/cypher/" rel="noopener">https://neo4j.com/docs/getting-started/cypher/</a> <a href="#fnref1" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn2" class="footnote-item"><p><a href="https://tinkerpop.apache.org/gremlin.html" rel="noopener">https://tinkerpop.apache.org/gremlin.html</a> <a href="#fnref2" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn3" class="footnote-item"><p><a href="https://pgql-lang.org/" rel="noopener">https://pgql-lang.org/</a> <a href="#fnref3" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn4" class="footnote-item"><p><a href="https://www.iso.org/standard/76120.html" rel="noopener">https://www.iso.org/standard/76120.html</a> <a href="#fnref4" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn5" class="footnote-item"><p><a href="https://www.iso.org/standard/79473.html" rel="noopener">https://www.iso.org/standard/79473.html</a> <a href="#fnref5" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn6" class="footnote-item"><p><a href="https://www.postgresql.org/docs/current/queries-with.html#QUERIES-WITH-SEARCH" rel="noopener">https://www.postgresql.org/docs/current/queries-with.html#QUERIES-WITH-SEARCH</a> <a href="#fnref6" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn7" class="footnote-item"><p><a href="https://www.postgresql.org/message-id/CAMbWs49-v9FGX+B=tsCxUq_FPX09ZNvXjj+TaTx0m-MAVmY5TA@mail.gmail.com" rel="noopener">https://www.postgresql.org/message-id/CAMbWs49-v9FGX+B=tsCxUq_FPX09ZNvXjj+TaTx0m-MAVmY5TA@mail.gmail.com</a> <a href="#fnref7" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn8" class="footnote-item"><p><a href="https://www.postgresql.org/message-id/33d590a7-4e26-41a8-acd4-51720dddf969%40eisentraut.org" rel="noopener">https://www.postgresql.org/message-id/33d590a7-4e26-41a8-acd4-51720dddf969%40eisentraut.org</a> <a href="#fnref8" class="footnote-backref">↩︎</a></p>
</li>
</ol>
</section>
 ]]></content>
			<author>
				<name>Ayoub Kazar</name>
			</author>
    </entry>
    <entry>
      <title>PostgreSQL comme base de données graphe, partie 0 : introduction, graphes, bases de données graphe</title>
      <link href="https://www.data-bene.io/fr/blog/postgresql-comme-bdd-graphe/" />
      <updated>2026-10-19T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/postgresql-comme-bdd-graphe/</id>
     <content type="html"><![CDATA[ <p><em>Cet article est le premier d’une série de quatre dont l’objectif est d’explorer les bases de données graphe et l’évolution du rôle de PostgreSQL dans le domaine. Nous introduirons les concepts fondamentaux puis discuterons de l’implémentation de SQL/PGQ dans PostgreSQL et son avenir. Nous comparerons les performances obtenues face aux solutions graphe sous PostgreSQL (par exemple Apache AGE), puis enfin à la trajectoire plus large des systèmes relationnels intégrant les charges de travail graphe.</em></p>
<h2 id="quest-ce-quun-graphe"><a class="heading-anchor" href="#quest-ce-quun-graphe">Qu’est-ce qu’un graphe ?</a></h2>
<p><strong>Un graphe est un ensemble d’éléments et un ensemble de connexions entre ces éléments</strong>. La définition est simple!<br>
Les éléments sont appelés <em>sommets</em> (ou nœuds) et les connexions sont appelées <em>arêtes</em> (ou relations).</p>
<p>Formellement, un graphe $G $ est modélisé comme un couple $(V, E)$, où $V $ est un ensemble de sommets et $e $ est un sous-ensemble du produit cartésien de $V $ par lui-même, représentant un ensemble d’arêtes :<br>
$E \subseteq V \times V$</p>
<p>On distingue trois types de graphes : orientés, non orientés et pondérés.</p>
<ol class="list">
<li>
<p>Pour un <strong>graphe orienté</strong>, une arête $e $ est le couple ordonné $(u, v)$ dans $e $, où $u $ est le sommet source et $V $ est le sommet destination; un exemple est l’abonnement sur Twitter, où la relation a une direction spécifique :<br>
arête $e = (u, v) \in E$</p>
</li>
<li>
<p>Pour un <strong>graphe non orienté</strong>, une arête $e $ est un couple non ordonné contenant $u $ et $V $ dans $e $ ; un exemple est l’amitié sur Facebook, où la relation est mutuelle :<br>
arête $e = { u, v } \in E$</p>
</li>
<li>
<p>Un <strong>graphe pondéré</strong> étend cette structure en un triplet $(V, E, w)$, où $w$ est une fonction qui associe à chaque arête dans $e $ un nombre réel (un poids), utile pour représenter des distances, des coûts ou des forces :<br>
triplet $(V, E, w)$ où $w: E \to \mathbb{R}$</p>
</li>
</ol>
<!--Formally, a graph $G $ is modeled as a tuple $(V, E)$ where $V $ is a set of vertices and $E \subseteq V \times V$ is a set of edges. We write $|V| = n$ and $|E| = m$. For a directed graph, an edge $e = (u, v) \in E$ is an ordered pair where $u $ is the source vertex and $V $ is the destination (think Twitter follows, where the relationship has a direction). For an undirected graph, an edge $e = \{u, v\} \in E$ is an unordered pair (think Facebook friendships, where the relationship is mutual). A weighted graph extends this as a triple $(V, E, w)$ where $w: E \to \mathbb{R}$ maps each edge to a real-valued weight, useful for representing distances, costs, strengths…-->
<h2 id="ou-sont-les-graphes"><a class="heading-anchor" href="#ou-sont-les-graphes">Où sont les graphes ?</a></h2>
<p>La puissance du modèle graphe réside dans son universalité. Dès qu’on commence à chercher, les graphes sont partout.</p>
<ul class="list">
<li><strong>Les réseaux sociaux</strong> représentent l’amitié, les abonnements et les interactions comme des arêtes connectant des sommets utilisateurs.<br>
<em>Savoir si Alice connaît Bob par l’intermédiaire d’autres personnes</em><br>
<em>est essentiellement un parcours du graphe pour trouver cette relation.</em></li>
</ul>
<ul class="list">
<li>
<p><strong>Les systèmes de détection de fraude</strong>  modélisent les transactions bancaires entre comptes sous forme de graphes. Les activités frauduleuses génèrent des structures particulières très faciles à repérer telles des cycles ou des amas denses de relations transactions-comptes.<br>
<em>Les relations entre entités révèlent souvent la fraude plus fiablement que les entités elles-mêmes.</em></p>
</li>
<li>
<p><strong>Les chaînes d’approvisionnement et la logistique</strong> utilisent les graphes pour modéliser les dépendances entre fournisseurs, entrepôts et expéditions.</p>
</li>
<li>
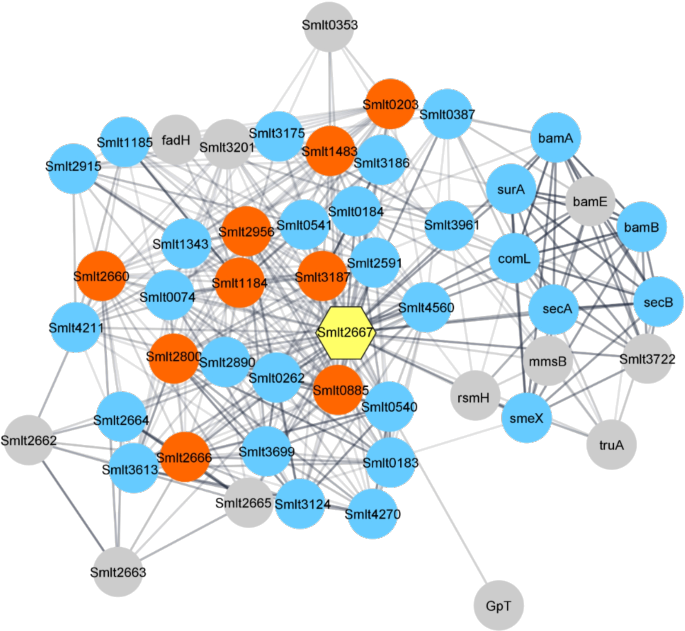
<p>Les biologistes représentent <strong>les réseaux d’interaction protéique et les relations médicament-cible</strong>.<br>
<img src="/assets/images/blog/protein_network_transparent.png" alt="protein_network_transparent" src="/assets/images/blog/protein_network_transparent.png" alt="" width="80%" eleventy:widths="650,960,1400"></p>
</li>
<li>
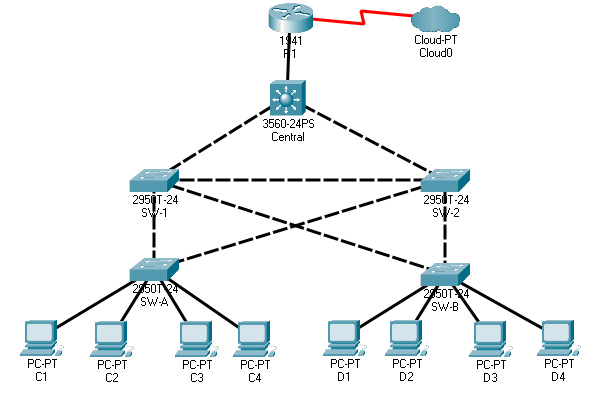
<p><strong>Les réseaux informatiques</strong> utilisent les graphes pour représenter les topologies.</p>
</li>
</ul>
<p><img src="/assets/images/blog/stp_topology_transparent.png" alt="stp_topology_transparent" src="/assets/images/blog/stp_topology_transparent.png" alt="" width="80%" eleventy:widths="650,960,1400"></p>
<ul class="list">
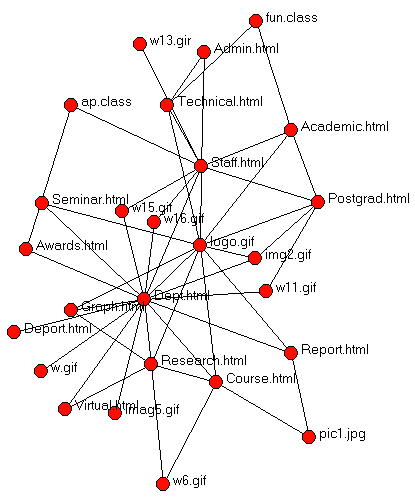
<li><strong>Le Web</strong> est un autre exemple de graphe.<br>
<em>Les pages sont des sommets, les hyperliens sont des arêtes orientées, et le graphe résultant est l’une des structures les plus vastes et les plus étudiées en informatique</em> :</li>
</ul>
<p><img src="/assets/images/blog/web_graph_transparent.png" alt="web_graph_transparent" src="/assets/images/blog/web_graph_transparent.png" alt="" width="80%" eleventy:widths="650,960,1400"></p>
<h2 id="modeliser-comme-un-graphe"><a class="heading-anchor" href="#modeliser-comme-un-graphe">Modéliser comme un graphe</a></h2>
<p>Ce que partagent les exemples de domaines ci-dessus sont des <strong>propriétés</strong> qui font du <strong>graphe</strong> une solution intuitive pour nous, êtres humains. Les relations sont aussi importantes que les entités elles-mêmes.<br>
Le schéma est souvent irrégulier ou évolutif. Les <strong>requêtes</strong> suivent fréquemment des chaînes de connexions dont la longueur ou la forme n’est pas connue à l’avance.</p>
<p><strong>Les graphes sont également efficaces parce qu’ils sont faciles à raisonner visuellement</strong>. Les êtres humains comprennent mieux les choses avec des exemples, et un graphe rend les relations explicites. Cette clarté visuelle et structurelle se traduit souvent par des modèles de données et des algorithmes plus faciles à expliquer et à questionner.</p>
<p>Le modèle défini au début de cet article, un ensemble de sommets et un ensemble d’arêtes sans donnée attachée, sous-tend une grande partie de la théorie classique des graphes et constitue la base des frameworks de traitement de graphes et des systèmes de gestion de bases de données graphe. Il est toutefois trop limité pour la plupart des scénarios de bases de données réels, car il ne transporte aucune information au-delà de la structure. Les modèles plus riches utilisés dans les bases de données graphe sont construits sur cette base.</p>
<ul class="list">
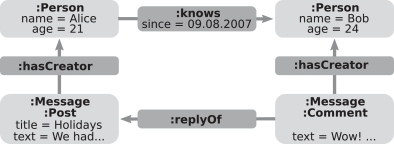
<li>Le <strong>Labeled Property Graph (LPG)</strong> est le modèle conceptuel standard utilisé par la plupart des systèmes de bases de données graphe. Il enrichit le graphe simple par deux mécanismes : les <strong>labels</strong>, qui classent les sommets et les arêtes en types, et les <strong>propriétés</strong>, qui attachent des données arbitraires de type clé-valeur aux sommets et aux arêtes individuels.<br>
Un sommet pourrait avoir le label <code>Person</code> et les propriétés <code>name='Alice'</code> et <code>age=21</code>.<br>
Une arête pourrait avoir le label <code>KNOWS</code> et la propriété <code>since = &quot;09.08.2007&quot;</code>.</li>
</ul>
<p><a href="https://dl.acm.org/doi/10.1145/3604932#sec-3-3-2" target="_blank" rel="noopener"><img src="/assets/images/blog/csur-2022-0455-f02.png" alt="Exemple de Labeled Property Graph, adapté de Besta et al." src="/assets/images/blog/csur-2022-0455-f02.png" alt="" width="80%" eleventy:widths="650,960,1400"></a></p>
<p>D’autres variantes du LPG sont implémentées par d’autres systèmes avec de légères extensions ou restrictions ; par exemple, <a href="https://neo4j.com/" target="_blank" rel="noopener">Neo4j</a> prend en charge un nombre arbitraire de labels par sommet mais limite les arêtes à exactement un label.</p>
<ul class="list">
<li>Le <strong>Resource Description Framework (RDF)</strong> adopte une approche différente. Le RDF représente l’information comme des collections de triplets sujet, prédicat, objet $(s, p, o)$.<br>
Si les systèmes basés sur le RDF constituent une part significative du paysage des bases de données graphe, ils suivent un modèle de données différent du LPG et <strong>sont hors du cadre de cette série</strong>. Nous le mentionnons uniquement pour le contexte, cette série d’articles étant centrée sur les bases de données graphe de type “labeled property graph”.</li>
</ul>
<h2 id="les-nombreuses-formes-des-bases-de-donnees-graphe"><a class="heading-anchor" href="#les-nombreuses-formes-des-bases-de-donnees-graphe">Les nombreuses formes des bases de données graphe</a></h2>
<p>Le paysage des bases de données graphe est hétérogène. Les systèmes diffèrent fondamentalement dans la manière dont ils stockent les graphes, les modèles de données qu’ils supportent et les langages de requête qu’ils exposent.</p>
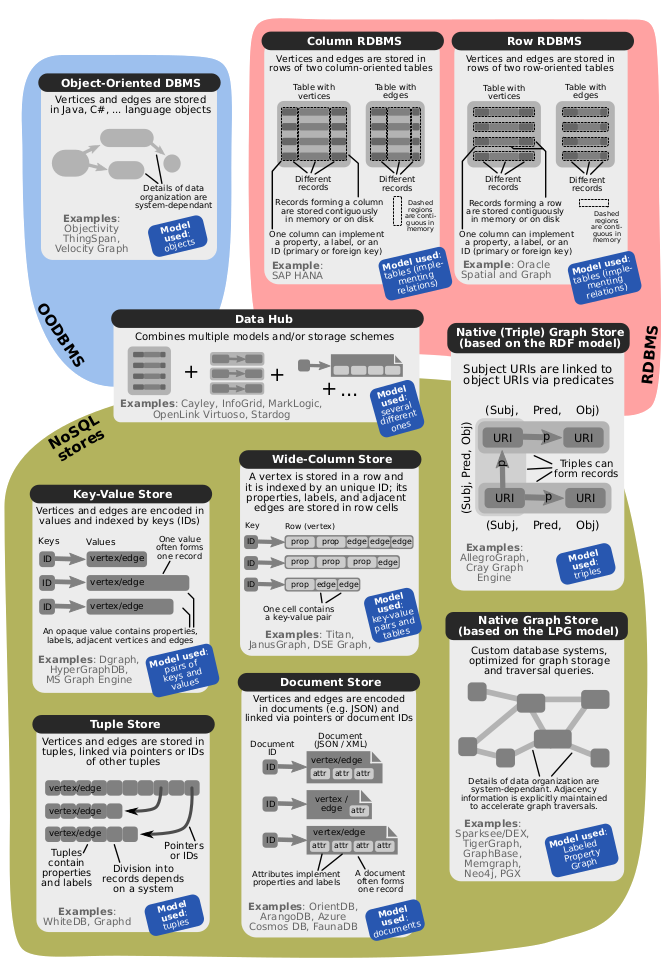
<p><a href="https://dl.acm.org/doi/10.1145/3604932#sec-5" target="_blank" rel="noopener"><img src="/assets/images/blog/graph_db_models_transparent.png" alt="Aperçu des différents backends de stockage graphe" src="/assets/images/blog/graph_db_models_transparent.png" alt="" width="80%" eleventy:widths="650,960,1400"></a></p>
<p><strong>Les bases de données graphe natives</strong> sont conçues de A à Z autour du modèle graphe. Leurs schémas de stockage et leurs moteurs de requête sont pensés avec les schémas d’accès aux graphes comme préoccupation principale : elles visent à « suivre les pointeurs », ou à accéder à l’adjacence directement, de sorte que la navigation « ne devienne pas un JOIN ».<br>
Neo4j en est l’exemple le plus marquant. Pendant longtemps, son moteur de stockage utilisait des enregistrements de taille fixe avec des pointeurs directs entre eux, et c’était essentiellement ainsi que les gens décrivaient le stockage graphe natif.<br>
Après une quinzaine d’années, en 2024, Neo4j a introduit un format de blocs qui co-localise les données apparentées dans des blocs de longueur variable à l’intérieur de pages <sup class="footnote-ref"><a href="#fn1" id="fnref1">[1]</a></sup>. Bien que cette prise de conscience tardive soit un progrès, elle implique que la description « natif équivaut à suivre des pointeurs » n’est plus tout à fait exacte.<br>
La définition utile devrait donc être comportementale, c’est-à-dire que les systèmes natifs tentent de rendre l’accès à l’adjacence direct, que ce soit par des pointeurs, des blocs co-localisés ou d’autres schémas spécifiques aux graphes.</p>
<p><strong>Les bases de données graphe non natives</strong> reprennent un backend mature existant ; une base relationnelle, orientée document ou clé-valeur, et construisent des capacités graphe par-dessus <sup class="footnote-ref"><a href="#fn2" id="fnref2">[2]</a></sup>. Les deux classes sont des bases de données graphe au sens où elles stockent, interrogent et gèrent des données de type graphe, mais leurs composants internes sont fondamentalement différents, ce qui implique que des optimisations spécifiques aux graphes sont disponibles, adapatées au backend.<br>
En pratique, la différence porte davantage sur l’endroit où l’effort d’ingénierie est investi : par exemple, les systèmes non natifs héritent de décennies de travail en contrôle de concurrence, indexation, optimisation des requêtes et bien d’autres composants de SGBD.</p>
<hr>
<p><strong>Une étude</strong> d’une centaine de systèmes de bases de données graphe révèle qu’environ 66 % sont non natifs. La répartition des modèles de données sous-jacents se décompose comme suit : 34 % de stockage graphe natif, 24 % de bases de données relationnelles, 24 % de stockages clé-valeur ou à colonnes larges, et 18 % de stockages orientés document. Cela a du sens : on souhaite rendre un SGBD existant capable de supporter les requêtes graphe si possible, offrant ainsi aux utilisateurs la meilleure interface possible.</p>
<p>C’est précisément à cet endroit que PostgreSQL entre en jeu. En tant que base de données relationnelle mature, elle représente une part massive de cet écosystème non natif à travers des extensions et de nouvelles normes SQL.</p>
<!-- *That is enough vocabulary to start. In the next post, we look at SQL/PGQ in PostgreSQL: what it does, how it is implemented, and where it stands today.* -->
<h2 id="points-cles"><a class="heading-anchor" href="#points-cles">Points clés</a></h2>
<p>Avant de passer à l’implémentation technique, rappelons les concepts fondamentaux de cette introduction :</p>
<ul class="list">
<li><strong>Les graphes sont universels :</strong> Au fond, ils ne sont que des sommets (nœuds) et des arêtes (relations), ce qui les rend idéaux pour des données complexes et interconnectées comme les réseaux sociaux ou les réseaux de fraude.</li>
<li><strong>Le LPG est la norme de l’industrie :</strong> Le modèle Labeled Property Graph étend les graphes simples en permettant d’attacher des labels et des propriétés clé-valeur aux nœuds et aux arêtes.</li>
<li><strong>Natif vs. non-natif est une distinction comportementale :</strong> Les bases de données natives (comme Neo4j) optimisent l’accès direct à l’adjacence, tandis que les bases non natives exploitent des moteurs de niveau entreprise existants (relationnels, orientés document) pour traiter les charges de travail graphe.</li>
<li><strong>Le paysage est hybride :</strong> Plus de 66 % des solutions de bases de données graphe sont construites sur des backends non graphe, prouvant qu’il n’est pas toujours nécessaire de déployer une nouvelle base de données native pour interroger des structures de type graphe.</li>
</ul>
<h2 id="et-maintenant"><a class="heading-anchor" href="#et-maintenant">Et maintenant ?</a></h2>
<p>Maintenant que nous avons posé le vocabulaire de base, nous pouvons explorer comment intégrer ce modèle dans le monde relationnel. Dans <a href="/fr/blog/postgresql-comme-bdd-graphe-part-1/">la <strong>partie 1</strong></a>, nous plongerons directement dans <strong>SQL/PGQ dans PostgreSQL</strong> : ce que cette nouvelle norme apporte, comment elle est implémentée en interne, et les limitations actuelles.</p>
<!-- 👉 **Quelle est votre stack actuelle ?** Utilisez-vous une base de données graphe native, ou souhaitez-vous étendre votre base de données relationnelle existante ? Dites-le moi dans les commentaires ci-dessous ! -->
<hr class="footnotes-sep">
<section class="footnotes">
<ol class="footnotes-list">
<li id="fn1" class="footnote-item"><p><a href="https://neo4j.com/docs/operations-manual/current/database-internals/store-formats/" target="_blank" rel="noopener">Neo4j store formats</a> <a href="#fnref1" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn2" class="footnote-item"><p>Plusieurs images empruntées à <a href="https://dl.acm.org/doi/10.1145/3604932" target="_blank" rel="noopener">Besta, M. et al. (2023). Demystifying Graph Databases: Analysis and Taxonomy of Data Organization, System Designs, and Graph Queries. <em>ACM Computing Surveys</em>, 56(2), Art. 31.</a> <a href="#fnref2" class="footnote-backref">↩︎</a></p>
</li>
</ol>
</section>
 ]]></content>
			<author>
				<name>Ayoub Kazar</name>
			</author>
    </entry>
</feed>