<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom" xml:lang="fr">
  <title>Data Bene - Tag: 'Open Source'</title>
  <subtitle>Base de données relationnelles, open-source et adaptives.</subtitle>
  <link href="https://www.data-bene.io/fr/blog/tag/open-source/feed.xml" rel="self" type="application/atom+xml" />
  <updated>2026-10-21T00:00:00Z</updated>
  <id>https://www.data-bene.io/fr/blog/tag/open-source/feed.xml</id>
    <entry>
      <title>PostgreSQL comme base de données graphique, partie 1: SQL/PGQ dans PostgreSQL</title>
      <link href="https://www.data-bene.io/fr/blog/postgresql-comme-bdd-graphe-part-1/" />
      <updated>2026-10-21T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/postgresql-comme-bdd-graphe-part-1/</id>
     <content type="html"><![CDATA[ <p><em>Cet article est le deuxième d’une série consacrée aux bases de données graphiques et à PostgreSQL. <a href="/fr/blog/postgresql-comme-bdd-graphe/">Le premier</a> a posé les bases: qu’est-ce qu’un graphe, ce qu’on peut modéliser comme graphe, et le paysage des systèmes graphiques. Celui-ci passe du général au spécifique: comment on interroge les graphes, pourquoi SQL peut être maladroit pour cela, et ce que SQL/PGQ change. Il s’achève sur l’implémentation PostgreSQL, les raisons de son annulation, et quelques notes sur les fonctionnalités principales encore à venir.</em></p>
<h2 id="les-langages-dinterrogation-des-graphes"><a class="heading-anchor" href="#les-langages-dinterrogation-des-graphes">Les langages d’interrogation des graphes</a></h2>
<p>Dans <a href="/fr/blog/postgresql-comme-bdd-graphe/">l’article précédent</a>, nous avons terminé par l’observation que les bases de données graphiques existent sous de nombreuses formes, qu’elles diffèrent dans leur façon de stocker les graphes et les modèles de données supportés. Elles diffèrent aussi sur la manière de les interroger.</p>
<p>Contrairement au monde relationnel, qui s’est convergé précocement vers SQL et l’a conservé comme standard dominant pendant des décennies, l’écosystème des graphes a engendré une prolifération de langages:</p>
<ul class="list">
<li>Cypher<sup class="footnote-ref"><a href="#fn1" id="fnref1">[1]</a></sup>, créé chez Neo4j, représente les motifs en ASCII art:<br>
<code>(a:Person)-[:KNOWS]-&gt;(b:Person)</code> ;</li>
<li>Gremlin<sup class="footnote-ref"><a href="#fn2" id="fnref2">[2]</a></sup>, issu d’Apache TinkerPop, est impératif et basé sur des étapes:<br>
<code>g.V().hasLabel('Person').out('KNOWS')</code> ;</li>
<li>PGQL<sup class="footnote-ref"><a href="#fn3" id="fnref3">[3]</a></sup>, d’Oracle, intègre les motifs de graphe dans une enveloppe de type SQL ;</li>
<li>Et en 2024, GQL<sup class="footnote-ref"><a href="#fn4" id="fnref4">[4]</a></sup> a été ratifié comme norme ISO/IEC 39075, le premier nouveau langage de requête de base de données à atteindre une standardisation ISO depuis SQL lui-même.</li>
</ul>
<p>Pour cette série, le plus pertinent est SQL/PGQ<sup class="footnote-ref"><a href="#fn5" id="fnref5">[5]</a></sup>, <strong>standardisé dans SQL:2023</strong>. C’est une extension de SQL qui permet de définir des graphes à propriétés sur des tables existantes et de les interroger avec une syntaxe de motifs de type GQL/PGQL intégrée dans un <code>SELECT</code> standard.</p>
<h2 id="a-quel-point-sql-est-il-bon-pour-les-graphes"><a class="heading-anchor" href="#a-quel-point-sql-est-il-bon-pour-les-graphes">À quel point SQL est-il bon pour les graphes ?</a></h2>
<p>Prenons un réseau social stocké dans deux tables: <code>person</code> et <code>knows</code>.<br>
Une requête Cypher qui cherche les amis d’amis ressemble à:</p>
<pre class="language-cypher"><code class="language-cypher"> <span class="token keyword">MATCH</span> <span class="token punctuation">(</span>a<span class="token operator">:</span><span class="token class-name">Person</span><span class="token punctuation">)</span><span class="token operator">-</span><span class="token punctuation">[</span><span class="token operator">:</span><span class="token relationship property">KNOWS</span><span class="token punctuation">]</span><span class="token operator">-></span><span class="token punctuation">(</span>b<span class="token punctuation">)</span><span class="token operator">-</span><span class="token punctuation">[</span><span class="token operator">:</span><span class="token relationship property">KNOWS</span><span class="token punctuation">]</span><span class="token operator">-></span><span class="token punctuation">(</span>c<span class="token punctuation">)</span>
 <span class="token keyword">WHERE</span> a<span class="token punctuation">.</span>name <span class="token operator">=</span> <span class="token string">'Alice'</span>
<span class="token keyword">RETURN</span> c<span class="token punctuation">.</span>name</code></pre>
<p>L’équivalent en SQL pur est une double jointure croisée:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">SELECT</span> <span class="token keyword">DISTINCT</span> c<span class="token punctuation">.</span>name
  <span class="token keyword">FROM</span> person a
  <span class="token keyword">JOIN</span> knows k1 <span class="token keyword">ON</span> k1<span class="token punctuation">.</span>src <span class="token operator">=</span> a<span class="token punctuation">.</span>id
  <span class="token keyword">JOIN</span> person b <span class="token keyword">ON</span> k1<span class="token punctuation">.</span>dst <span class="token operator">=</span> b<span class="token punctuation">.</span>id
  <span class="token keyword">JOIN</span> knows k2 <span class="token keyword">ON</span> k2<span class="token punctuation">.</span>src <span class="token operator">=</span> b<span class="token punctuation">.</span>id
  <span class="token keyword">JOIN</span> person c <span class="token keyword">ON</span> k2<span class="token punctuation">.</span>dst <span class="token operator">=</span> c<span class="token punctuation">.</span>id
 <span class="token keyword">WHERE</span> a<span class="token punctuation">.</span>name <span class="token operator">=</span> <span class="token string">'Alice'</span><span class="token punctuation">;</span></code></pre>
<p>Ce n’est pas mal. C’est verbeux, mais c’est expressible, le JOIN est explicite, et que ce soient deux sauts ou dix, chaque saut est conciste à écrire d’avantage de JOINs.</p>
<p>Essayons quelque chose de plus centré sur les graphes maintenant. Supposons que nous voulons toutes les personnes atteignables depuis Alice en cinq sauts <code>KNOWS</code>. En SQL/PGQ (très similaire à Cypher), c’est un seul motif:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">SELECT</span> c<span class="token punctuation">.</span>name
  <span class="token keyword">FROM</span> GRAPH_TABLE<span class="token punctuation">(</span>
          social_graph
    <span class="token keyword">MATCH</span> <span class="token punctuation">(</span>a <span class="token operator">IS</span> Person <span class="token keyword">WHERE</span> a<span class="token punctuation">.</span>name <span class="token operator">=</span> <span class="token string">'Alice'</span><span class="token punctuation">)</span><span class="token operator">-</span><span class="token punctuation">[</span><span class="token operator">IS</span> KNOWS<span class="token punctuation">]</span><span class="token operator">-</span><span class="token operator">></span>{<span class="token number">1</span><span class="token punctuation">,</span><span class="token number">5</span>}<span class="token punctuation">(</span>c <span class="token operator">IS</span> Person<span class="token punctuation">)</span>
  <span class="token keyword">COLUMNS</span> <span class="token punctuation">(</span>c<span class="token punctuation">.</span>name<span class="token punctuation">)</span>
<span class="token punctuation">)</span> <span class="token keyword">AS</span> g<span class="token punctuation">;</span></code></pre>
<p>En SQL, cela devient un peu lourd:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">WITH</span> RECURSIVE reachable<span class="token punctuation">(</span>id<span class="token punctuation">,</span> depth<span class="token punctuation">,</span> path<span class="token punctuation">)</span> <span class="token keyword">AS</span> <span class="token punctuation">(</span>
    <span class="token keyword">SELECT</span> p<span class="token punctuation">.</span>id
         <span class="token punctuation">,</span> <span class="token number">0</span>
         <span class="token punctuation">,</span> ARRAY<span class="token punctuation">[</span>p<span class="token punctuation">.</span>id<span class="token punctuation">]</span>
      <span class="token keyword">FROM</span> person p
     <span class="token keyword">WHERE</span> p<span class="token punctuation">.</span>name <span class="token operator">=</span> <span class="token string">'Alice'</span>
    <span class="token keyword">UNION</span> <span class="token keyword">ALL</span>
    <span class="token keyword">SELECT</span> k<span class="token punctuation">.</span>dst
         <span class="token punctuation">,</span> r<span class="token punctuation">.</span>depth <span class="token operator">+</span> <span class="token number">1</span>
         <span class="token punctuation">,</span> r<span class="token punctuation">.</span>path <span class="token operator">||</span> k<span class="token punctuation">.</span>dst
      <span class="token keyword">FROM</span> reachable r
      <span class="token keyword">JOIN</span> knows k <span class="token keyword">ON</span> k<span class="token punctuation">.</span>src <span class="token operator">=</span> r<span class="token punctuation">.</span>id
     <span class="token keyword">WHERE</span> r<span class="token punctuation">.</span>depth <span class="token operator">&lt;</span> <span class="token number">5</span>
       <span class="token operator">AND</span> k<span class="token punctuation">.</span>dst <span class="token operator">&lt;></span> <span class="token keyword">ALL</span><span class="token punctuation">(</span>r<span class="token punctuation">.</span>path<span class="token punctuation">)</span>
<span class="token punctuation">)</span>
<span class="token keyword">SELECT</span> <span class="token keyword">DISTINCT</span> p<span class="token punctuation">.</span>name
  <span class="token keyword">FROM</span> reachable r
  <span class="token keyword">JOIN</span> person p <span class="token keyword">ON</span> p<span class="token punctuation">.</span>id <span class="token operator">=</span> r<span class="token punctuation">.</span>id
 <span class="token keyword">WHERE</span> r<span class="token punctuation">.</span>depth <span class="token operator">></span> <span class="token number">0</span><span class="token punctuation">;</span></code></pre>
<p>L’auteur encode désormais la limite de profondeur, transporte le chemin dans un tableau pour éviter les cycles, et retire la ligne racine à la fin. PostgreSQL 14 a ajouté les clauses <code>SEARCH</code> et <code>CYCLE</code><sup class="footnote-ref"><a href="#fn6" id="fnref6">[6]</a></sup> qui masquent une partie de cette gestion administrative, mais la requête reste un calcul de point fixe récursif qui arrive à produire le bon résultat.</p>
<p>Bien que ce soit un parcours de graphe basique, les choses deviennent encore plus complexes. Pour les plus courts chemins, il faudrait suivre la distance et faire du “pruning”. Si on demande un tracé (pas de répétition d’arêtes), il faudrait suivre les arêtes, pas seulement les sommets.</p>
<h2 id="definir-et-interroger-un-graphe-en-sql/pgq"><a class="heading-anchor" href="#definir-et-interroger-un-graphe-en-sql/pgq">Définir et interroger un graphe en SQL/PGQ</a></h2>
<p>À partir d’ici, nous utilisons un exemple plus riche, situé dans la galaxie Star Wars. Les Jedi combattaient sur des planètes, et les Sith sur des stations. Les tables de sommets sont <code>jedi</code>, <code>sith</code>, <code>planet</code> et <code>station</code>, chacune avec un <code>id</code> et un <code>name</code>, plus un <code>title</code> pour les combattants et une <code>region</code> pour les lieux. Deux tables d’arêtes, <code>fought_on_planet</code> et <code>fought_on_station</code>, contiennent chacune un identifiant source, un identifiant destination, et le nom de la bataille.</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> jedi <span class="token punctuation">(</span>
    id     <span class="token keyword">BIGINT</span> <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span><span class="token punctuation">,</span>
    name   <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    title  <span class="token keyword">TEXT</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> sith <span class="token punctuation">(</span>
    id     <span class="token keyword">BIGINT</span> <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span><span class="token punctuation">,</span>
    name   <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    title  <span class="token keyword">TEXT</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> planet <span class="token punctuation">(</span>
    id      <span class="token keyword">BIGINT</span> <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span><span class="token punctuation">,</span>
    name    <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    region  <span class="token keyword">TEXT</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> station <span class="token punctuation">(</span>
    id      <span class="token keyword">BIGINT</span> <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span><span class="token punctuation">,</span>
    name    <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    region  <span class="token keyword">TEXT</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> fought_on_planet <span class="token punctuation">(</span>
    a       <span class="token keyword">BIGINT</span> <span class="token keyword">REFERENCES</span> jedi <span class="token punctuation">(</span>id<span class="token punctuation">)</span><span class="token punctuation">,</span>
    b       <span class="token keyword">BIGINT</span> <span class="token keyword">REFERENCES</span> planet <span class="token punctuation">(</span>id<span class="token punctuation">)</span><span class="token punctuation">,</span>
    battle  <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span> <span class="token punctuation">(</span>a<span class="token punctuation">,</span> b<span class="token punctuation">)</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span> fought_on_station <span class="token punctuation">(</span>
    a       <span class="token keyword">BIGINT</span> <span class="token keyword">REFERENCES</span> sith <span class="token punctuation">(</span>id<span class="token punctuation">)</span><span class="token punctuation">,</span>
    b       <span class="token keyword">BIGINT</span> <span class="token keyword">REFERENCES</span> station <span class="token punctuation">(</span>id<span class="token punctuation">)</span><span class="token punctuation">,</span>
    battle  <span class="token keyword">TEXT</span><span class="token punctuation">,</span>
    <span class="token keyword">PRIMARY</span> <span class="token keyword">KEY</span> <span class="token punctuation">(</span>a<span class="token punctuation">,</span> b<span class="token punctuation">)</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span></code></pre>
<p>Le graphe est déclaré sur celles-ci:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">CREATE</span> PROPERTY GRAPH galaxy
    VERTEX <span class="token keyword">TABLES</span> <span class="token punctuation">(</span>
        jedi    <span class="token keyword">KEY</span> <span class="token punctuation">(</span>id<span class="token punctuation">)</span> LABEL force_user PROPERTIES <span class="token punctuation">(</span>id<span class="token punctuation">,</span> name<span class="token punctuation">,</span> title<span class="token punctuation">)</span><span class="token punctuation">,</span>
        sith    <span class="token keyword">KEY</span> <span class="token punctuation">(</span>id<span class="token punctuation">)</span> LABEL force_user PROPERTIES <span class="token punctuation">(</span>id<span class="token punctuation">,</span> name<span class="token punctuation">,</span> title<span class="token punctuation">)</span><span class="token punctuation">,</span>
        planet  <span class="token keyword">KEY</span> <span class="token punctuation">(</span>id<span class="token punctuation">)</span> LABEL place      PROPERTIES <span class="token punctuation">(</span>id<span class="token punctuation">,</span> name<span class="token punctuation">,</span> region<span class="token punctuation">)</span><span class="token punctuation">,</span>
        station <span class="token keyword">KEY</span> <span class="token punctuation">(</span>id<span class="token punctuation">)</span> LABEL place      PROPERTIES <span class="token punctuation">(</span>id<span class="token punctuation">,</span> name<span class="token punctuation">,</span> region<span class="token punctuation">)</span>
    <span class="token punctuation">)</span>
    EDGE <span class="token keyword">TABLES</span> <span class="token punctuation">(</span>
        fought_on_planet
            SOURCE <span class="token keyword">KEY</span> <span class="token punctuation">(</span>a<span class="token punctuation">)</span>      <span class="token keyword">REFERENCES</span> jedi <span class="token punctuation">(</span>id<span class="token punctuation">)</span>
            DESTINATION <span class="token keyword">KEY</span> <span class="token punctuation">(</span>b<span class="token punctuation">)</span> <span class="token keyword">REFERENCES</span> planet <span class="token punctuation">(</span>id<span class="token punctuation">)</span>
            LABEL fought_at     PROPERTIES <span class="token punctuation">(</span>battle<span class="token punctuation">)</span><span class="token punctuation">,</span>
        fought_on_station
            SOURCE <span class="token keyword">KEY</span> <span class="token punctuation">(</span>a<span class="token punctuation">)</span>      <span class="token keyword">REFERENCES</span> sith <span class="token punctuation">(</span>id<span class="token punctuation">)</span>
            DESTINATION <span class="token keyword">KEY</span> <span class="token punctuation">(</span>b<span class="token punctuation">)</span> <span class="token keyword">REFERENCES</span> station <span class="token punctuation">(</span>id<span class="token punctuation">)</span>
            LABEL fought_at     PROPERTIES <span class="token punctuation">(</span>battle<span class="token punctuation">)</span>
    <span class="token punctuation">)</span><span class="token punctuation">;</span></code></pre>
<p>Les labels regroupent des tables: <code>force_user</code> couvre deux tables de sommets, <code>place</code> en couvre deux, et <code>fought_at</code> couvre les deux tables d’arêtes. Le graphe ne contient aucune donnée.<br>
Dans PostgreSQL, c’est un nouveau type de relation (<code>RELKIND_PROPGRAPH</code>) qui vit dans <code>pg_class</code> sans “heap” (table) et sans colonne propre, ce qui fait qu’il se comporte comme une vue. Cinq nouveaux catalogues (<code>pg_propgraph_element</code>, <code>pg_propgraph_label</code> et trois autres) enregistrent ses éléments, labels et propriétés.</p>
<p>L’interroger:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">SELECT</span> <span class="token operator">*</span>
<span class="token keyword">FROM</span> GRAPH_TABLE <span class="token punctuation">(</span>
            galaxy
      <span class="token keyword">MATCH</span> <span class="token punctuation">(</span>a <span class="token operator">IS</span> force_user<span class="token punctuation">)</span><span class="token operator">-</span><span class="token punctuation">[</span><span class="token operator">IS</span> fought_at<span class="token punctuation">]</span><span class="token operator">-</span><span class="token operator">></span><span class="token punctuation">(</span>b <span class="token operator">IS</span> place<span class="token punctuation">)</span>
    <span class="token keyword">COLUMNS</span> <span class="token punctuation">(</span>a<span class="token punctuation">.</span>name <span class="token keyword">AS</span> fighter<span class="token punctuation">,</span> b<span class="token punctuation">.</span>name <span class="token keyword">AS</span> battlefield<span class="token punctuation">,</span> b<span class="token punctuation">.</span>region<span class="token punctuation">)</span>
<span class="token punctuation">)</span><span class="token punctuation">;</span></code></pre>
<h3 id="comment-fonctionne-la-reecriture"><a class="heading-anchor" href="#comment-fonctionne-la-reecriture">Comment fonctionne la réécriture ?</a></h3>
<p>PostgreSQL n’a pas de nouveau nœud “exécuteur”. L’analyseur transforme <code>GRAPH_TABLE</code> en un nouveau type de “range-table”, <code>RTE_GRAPH_TABLE</code>. La réécriture, le même stade qui étend les vues, la remplace ensuite par une sous-requête ordinaire.<br>
Il procède en quatre étapes:</p>
<ol class="list">
<li>Le motif est lu de gauche à droite dans une liste de motifs d’éléments: sommets, arêtes dans les deux sens, et sous-motifs imbriqués.</li>
<li>Chaque nom de variable unique devient un facteur de chemin. Une variable qui apparaît deux fois, dans un cycle qui retourne à <code>a</code>, partage un même facteur, et ses prédicats sont conjoints par <code>AND</code>.</li>
<li>Chaque expression de label est résolue vers les tables qu’elle couvre, donnant un élément de chemin par table.</li>
<li>Chaque combinaison d’éléments le long du chemin est énumérée par un DFS (recherche en profondeur d’abord) récursif. Une combinaison n’est valide que si les clés source et destination de chaque table d’arêtes relient vraiment les deux tables de sommets voisines. Chaque combinaison valide devient un <code>JOIN</code> entre les tables d’arêtes et de sommets sur ces clés, et toutes sont combinées par <code>UNION ALL</code>.</li>
</ol>
<p>Dans notre requête, <code>force_user</code> a deux tables, <code>fought_at</code> en a deux, et <code>place</code> en a deux, il y a donc 2 × 2 × 2 = 8 combinaisons. Seulement deux sont valides: un Jedi sur une planète, et un Sith dans une station. La requête devient équivalente à:</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">SELECT</span> jedi<span class="token punctuation">.</span>name<span class="token punctuation">,</span> planet<span class="token punctuation">.</span>name<span class="token punctuation">,</span> planet<span class="token punctuation">.</span>region
  <span class="token keyword">FROM</span> jedi<span class="token punctuation">,</span> fought_on_planet<span class="token punctuation">,</span> planet
 <span class="token keyword">WHERE</span> jedi<span class="token punctuation">.</span>id <span class="token operator">=</span> fought_on_planet<span class="token punctuation">.</span>a
   <span class="token operator">AND</span> planet<span class="token punctuation">.</span>id <span class="token operator">=</span> fought_on_planet<span class="token punctuation">.</span>b
<span class="token keyword">UNION</span> <span class="token keyword">ALL</span>
<span class="token keyword">SELECT</span> sith<span class="token punctuation">.</span>name<span class="token punctuation">,</span> station<span class="token punctuation">.</span>name<span class="token punctuation">,</span> station<span class="token punctuation">.</span>region
  <span class="token keyword">FROM</span> sith<span class="token punctuation">,</span> fought_on_station<span class="token punctuation">,</span> station
 <span class="token keyword">WHERE</span> sith<span class="token punctuation">.</span>id <span class="token operator">=</span> fought_on_station<span class="token punctuation">.</span>a
   <span class="token operator">AND</span> station<span class="token punctuation">.</span>id <span class="token operator">=</span> fought_on_station<span class="token punctuation">.</span>b<span class="token punctuation">;</span></code></pre>
<p>À partir de ce point, le planificateur et l’exécuteur voient des jointures et une union, rien de spécifique aux graphes. Ceci a une certaine valeur car nous bénéficions des index, des statistiques, de l’interrogation parallèle et de tout ce que PostgreSQL possède — ce qui rappelle l’argument que nous faisons dans le <a href="/fr/blog/postgresql-comme-bdd-graphe/">précédent article</a> de la série sur les bases de données graphes construites sur des systèmes matures.</p>
<p><strong>Il y a ici une subtilité qui compte pour la lecture de tout benchmark comparant les deux formalismes.</strong></p>
<p>Dans un motif de longueur fixe, SQL/PGQ est obligé de toucher les tables de sommets. Le motif lie les sommets, donc la jointure vers la table de sommets fait partie de la sémantique même lorsqu’aucune propriété de sommet n’est demandée, car il n’y a pas de clés étrangères (FK). Si vous modélisiez le même graphe vous-même en SQL pur et aviez seulement besoin de la traversée des arêtes, à condition d’avoir défini des FK, joindre les tables d’arêtes seules suffit.</p>
<p><em>Note: il y a un effort récent, non validé, de la part de hackers PostgreSQL pour éliminer les inner joins basés sur les clés étrangères, ce qui serait bénéfique pour la réécriture SQL/PGQ + FK sur les tables élémentaires du graphe<sup class="footnote-ref"><a href="#fn7" id="fnref7">[7]</a></sup>.</em></p>
<h3 id="ce-qui-est-supporte-et-ce-qui-ne-lest-pas"><a class="heading-anchor" href="#ce-qui-est-supporte-et-ce-qui-ne-lest-pas">Ce qui est supporté et ce qui ne l’est pas</a></h3>
<p>La norme recense 100 fonctionnalités. L’implémentation validée en couvrait 26. Elle supporte les motifs graphiques avec <code>WHERE</code>, les motifs de sommets, les motifs d’arêtes sous forme complète et abrégée, la disjonction de labels (<code>label1|label2</code>), les références de propriétés, <code>GRAPH_TABLE</code>, le DDL incluant <code>ALTER</code> et <code>DROP</code>, plusieurs labels par table élémentaire, et les vues comme tables élémentaires.</p>
<p>Les plus intéressantes des 74 manquantes relèvent (pour la plupart) de cinq mécanismes que la norme définit au-dessus d’un motif de base:</p>
<table>
<thead>
<tr>
<th>Mécanisme</th>
<th>Ce qu’il décide</th>
<th>PostgreSQL</th>
</tr>
</thead>
<tbody>
<tr>
<td>Quantificateurs: <code>{n,m}</code>, <code>{n}</code>, <code>+</code>, <code>*</code></td>
<td>Le nombre de sauts couverts par un motif</td>
<td>Non supporté</td>
</tr>
<tr>
<td></td>
<td></td>
<td></td>
</tr>
<tr>
<td>Modes de chemin: <code>WALK</code>, <code>TRAIL</code>, <code>SIMPLE</code>, <code>ACYCLIC</code></td>
<td>Quels chemins sont admissibles (quoi qui peut se répéter)</td>
<td>Comporte comme <code>WALK</code>, mots-clés rejetés</td>
</tr>
<tr>
<td></td>
<td></td>
<td></td>
</tr>
<tr>
<td>Préfixes de recherche de chemin: <code>ALL</code>, <code>ANY</code>, <code>ALL SHORTEST</code>, <code>SHORTEST n</code></td>
<td>Quels chemins admissibles sont retournés</td>
<td>Seulement <code>ALL</code>, le défaut</td>
</tr>
<tr>
<td></td>
<td></td>
<td></td>
</tr>
<tr>
<td>Modes de correspondance: <code>REPEATABLE ELEMENTS</code>, <code>DIFFERENT EDGES</code></td>
<td>Si les arêtes peuvent se lier deux fois</td>
<td>Seulement <code>REPEATABLE ELEMENTS</code></td>
</tr>
<tr>
<td></td>
<td></td>
<td></td>
</tr>
<tr>
<td>Plusieurs motifs de chemin séparés par des virgules dans un <code>MATCH</code></td>
<td>Jointure de motifs sur des variables partagées</td>
<td>Patch existant, retardé après les quantificateurs</td>
</tr>
</tbody>
</table>
<p>PostgreSQL n’est pas seul ici. Le SQL/PGQ d’Oracle est tout aussi réduit, DuckPGQ n’ajoute que <code>ANY SHORTEST</code>, et l’ancien PGQL d’Oracle supporte la plupart de ces fonctionnalités.</p>
<h3 id="lannulation-git-revert"><a class="heading-anchor" href="#lannulation-git-revert">L’annulation (“git revert”)</a></h3>
<p>SQL/PGQ a été validé le 16 mars 2026 pour PostgreSQL 19. Début septembre, une discussion sur <code>pgsql-hackers</code> concernant certains problèmes dans sa représentation/catalogue et ses dépendances d’objets s’est achevé par une décision de le retirer.<br>
Les reviewers ont estimé qu’il devait être retiré de cette version afin que les problèmes puissent être corrigés proprement pour 20, sans la pression de la compatibilité ascendante.</p>
<p>La fonctionnalité devrait revenir dans une version future. La réécriture elle-même n’est pas la partie en cours de refonte, elle devrait donc survivre, inchangée, ce qui signifie que le travail supplémentaire — VLE (variable length edge), motifs multi-chemins, etc. — pourra s’appuyer sur le même socle.</p>
<p>Il est d’ailleurs à noter que tout cela n’a pas à être nécessairement dans le noyau. PostgreSQL n’a pas de parser hook, donc une extension ne peut pas ajouter de grammaire, et les parser hooks ont été proposés et discutés à maintes reprises sans aboutir. La dernière mention concernait la manière de publier SQL/PGQ comme fonctionnalité expérimentale<sup class="footnote-ref"><a href="#fn8" id="fnref8">[8]</a></sup>.<br>
Il ne reste à SQL/PGQ que deux options: travailler dans le noyau, ou faire ce que fait Apache AGE et parser une chaîne à l’exécution ; bien sûr, la deuxième est un élément pour une extension, pas pour une fonctionnalité du noyau.<br>
<strong>Si les extensions avaient pu étendre le parseur, cela aurait pu être construit et prouvé hors de l’arbre, puis ensuite considéré pour un module contrib ou pour le noyau. Ce n’est pas un argument en faveur des parser hooks. C’est une observation sur là où le coût de ne pas les avoir finit par peser.</strong></p>
<h3 id="la-fonctionnalite-que-tout-le-monde-reclame"><a class="heading-anchor" href="#la-fonctionnalite-que-tout-le-monde-reclame">La fonctionnalité que tout le monde réclame</a></h3>
<p>Des morceaux manquants, l’un domine chaque conversation sur les requêtes de graphe: <strong>les arêtes de longueur variable</strong> (VLE).<br>
C’est la fonctionnalité que les utilisatrices et utilisateurs de graphes réclament en premier, et c’est souvent la raison pour laquelle on se tourne vers un langage de requête de graphe plutôt que d’écrire des jointures. La difficulté est proportionnelle à l’échelle. Un motif borné sur deux ou trois sauts peut être fait avec une réécriture similaire vers des jointures. Un motif pouvant atteindre des centaines de sauts, ou s’exécuter de manière non bornée jusqu’à épuisement du graphe, est un problème différent avec ses propres exigences de mémoire, de terminaison et de gestion des cycles.</p>
<p>La norme rend cela plus difficile qu’il n’y paraît, car elle définit plusieurs mécanismes et fonctionnalités qui interagissent avec elle. Comment le motif s’étend, quels chemins comptent comme admissibles, et lesquels de ceux-ci sont retournés sont décidés indépendamment, et chaque combinaison implique une stratégie d’exécution différente. Tous les chemins sur une profondeur bornée, un seul chemin le plus court, et les extrémités atteignables distinctes sont des motifs différents dont il faut tenir compte dans la conception. Bien sûr, on NE peut PAS tout supporter, mais il est important de garder ces sémantiques en tête.</p>
<p>Les implémentations varient. Une approche est une nouvelle réécriture, cette fois vers des CTE récursifs, s’appuyant sur les clauses <code>SEARCH</code> et <code>CYCLE</code> et faisant beaucoup de gestion administrative directement dans la requête pour les différentes sémantiques. En bout de ligne, c’est un BFS (recherche en largeur) basé sur des ensembles exprimé sous forme de jointures ; c’est acceptable mais ce ne sera ni performant ni flexible à combiner avec d’autres fonctionnalités comme les variables de chemin.</p>
<p>Une autre approche étend chaque longueur possible dans son propre <code>UNION ALL</code>, ce qui ne peut pas gérer le cas non borné. C’est une très mauvaise idée ; Oracle fait ça. Puis il y a les stratégies au niveau de l’exécuteur: DFS avec état de chemin pour le backtracking, ou BFS exécuté directement dans l’exécuteur (tous avec de nouveaux nœuds exécuteur). Chacune est adaptée à un objectif différent, qu’il s’agisse d’accessibilité, de plus court chemin, ou d’énumération de tous les chemins possibles. L’implémentation future prendra en compte toutes celles-ci, <strong>autrement on ne peut pas considérer Postgres dans la course, en aucune manière.</strong></p>
<h2 id="points-cles"><a class="heading-anchor" href="#points-cles">Points clés</a></h2>
<p>SQL/PGQ réécrit les motifs de graphe en jointures — pas de nouveaux nœuds exécuteur, pas de moteur de graphe. Le planificateur gère le reste avec les index, les statistiques et l’interrogation parallèle.</p>
<p>L’implémentation validée couvrait 26 des 100 fonctionnalités de la norme, de quoi prouver l’approche mais en s’arrêtant avant les problèmes difficiles. Les quantificateurs, les modes de chemin et les arêtes de longueur variable étaient intentionnellement différés.</p>
<p>L’annulation est lié au “timing”. Les catalogues et le suivi des dépendances nécessitent une base plus propre pour PostgreSQL 20. Le moteur de réécriture lui-même n’est pas en cours de refonte.</p>
<p>La gestion des arêtes de longueur variable est la fonctionnalité requise. La norme définit plusieurs mécanismes au-dessus du VLE qui impliquent différentes stratégies d’exécution — BFS basé sur des ensembles via des CTE récursives, bras <code>UNION ALL</code> par longueur, ou DFS/BFS au niveau de l’exécuteur avec de nouveaux nœuds. Chacune sert un objectif différent.</p>
<p>Sans parser hooks, SQL/PGQ doit vivre dans le noyau ou utiliser un analyseur de chaîne à l’exécution.</p>
<h2 id="et-maintenant"><a class="heading-anchor" href="#et-maintenant">Et maintenant ?</a></h2>
<p>Le prochain article examine les autres options de graphes dans PostgreSQL: Apache AGE, pgRouting, et le cas pratique pour ou contre chacune.<br>
Ensuite, un benchmark comparant SQL/PGQ à Apache AGE.<br>
Et enfin, à quoi ressemble la vision à long terme pour les requêtes de graphe dans PostgreSQL, et pourquoi la trajectoire pointe vers l’absorption des charges de travail des graphes dans les systèmes relationnels.</p>
<hr class="footnotes-sep">
<section class="footnotes">
<ol class="footnotes-list">
<li id="fn1" class="footnote-item"><p><a href="https://neo4j.com/docs/getting-started/cypher/" rel="noopener">https://neo4j.com/docs/getting-started/cypher/</a> <a href="#fnref1" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn2" class="footnote-item"><p><a href="https://tinkerpop.apache.org/gremlin.html" rel="noopener">https://tinkerpop.apache.org/gremlin.html</a> <a href="#fnref2" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn3" class="footnote-item"><p><a href="https://pgql-lang.org/" rel="noopener">https://pgql-lang.org/</a> <a href="#fnref3" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn4" class="footnote-item"><p><a href="https://www.iso.org/standard/76120.html" rel="noopener">https://www.iso.org/standard/76120.html</a> <a href="#fnref4" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn5" class="footnote-item"><p><a href="https://www.iso.org/standard/79473.html" rel="noopener">https://www.iso.org/standard/79473.html</a> <a href="#fnref5" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn6" class="footnote-item"><p><a href="https://www.postgresql.org/docs/current/queries-with.html#QUERIES-WITH-SEARCH" rel="noopener">https://www.postgresql.org/docs/current/queries-with.html#QUERIES-WITH-SEARCH</a> <a href="#fnref6" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn7" class="footnote-item"><p><a href="https://www.postgresql.org/message-id/CAMbWs49-v9FGX+B=tsCxUq_FPX09ZNvXjj+TaTx0m-MAVmY5TA@mail.gmail.com" rel="noopener">https://www.postgresql.org/message-id/CAMbWs49-v9FGX+B=tsCxUq_FPX09ZNvXjj+TaTx0m-MAVmY5TA@mail.gmail.com</a> <a href="#fnref7" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn8" class="footnote-item"><p><a href="https://www.postgresql.org/message-id/33d590a7-4e26-41a8-acd4-51720dddf969%40eisentraut.org" rel="noopener">https://www.postgresql.org/message-id/33d590a7-4e26-41a8-acd4-51720dddf969%40eisentraut.org</a> <a href="#fnref8" class="footnote-backref">↩︎</a></p>
</li>
</ol>
</section>
 ]]></content>
			<author>
				<name>Ayoub Kazar</name>
			</author>
    </entry>
    <entry>
      <title>PostgreSQL comme base de données graphe, partie 0 : introduction, graphes, bases de données graphe</title>
      <link href="https://www.data-bene.io/fr/blog/postgresql-comme-bdd-graphe/" />
      <updated>2026-10-19T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/postgresql-comme-bdd-graphe/</id>
     <content type="html"><![CDATA[ <p><em>Cet article est le premier d’une série de quatre dont l’objectif est d’explorer les bases de données graphe et l’évolution du rôle de PostgreSQL dans le domaine. Nous introduirons les concepts fondamentaux puis discuterons de l’implémentation de SQL/PGQ dans PostgreSQL et son avenir. Nous comparerons les performances obtenues face aux solutions graphe sous PostgreSQL (par exemple Apache AGE), puis enfin à la trajectoire plus large des systèmes relationnels intégrant les charges de travail graphe.</em></p>
<h2 id="quest-ce-quun-graphe"><a class="heading-anchor" href="#quest-ce-quun-graphe">Qu’est-ce qu’un graphe ?</a></h2>
<p><strong>Un graphe est un ensemble d’éléments et un ensemble de connexions entre ces éléments</strong>. La définition est simple!<br>
Les éléments sont appelés <em>sommets</em> (ou nœuds) et les connexions sont appelées <em>arêtes</em> (ou relations).</p>
<p>Formellement, un graphe $G $ est modélisé comme un couple $(V, E)$, où $V $ est un ensemble de sommets et $e $ est un sous-ensemble du produit cartésien de $V $ par lui-même, représentant un ensemble d’arêtes :<br>
$E \subseteq V \times V$</p>
<p>On distingue trois types de graphes : orientés, non orientés et pondérés.</p>
<ol class="list">
<li>
<p>Pour un <strong>graphe orienté</strong>, une arête $e $ est le couple ordonné $(u, v)$ dans $e $, où $u $ est le sommet source et $V $ est le sommet destination; un exemple est l’abonnement sur Twitter, où la relation a une direction spécifique :<br>
arête $e = (u, v) \in E$</p>
</li>
<li>
<p>Pour un <strong>graphe non orienté</strong>, une arête $e $ est un couple non ordonné contenant $u $ et $V $ dans $e $ ; un exemple est l’amitié sur Facebook, où la relation est mutuelle :<br>
arête $e = { u, v } \in E$</p>
</li>
<li>
<p>Un <strong>graphe pondéré</strong> étend cette structure en un triplet $(V, E, w)$, où $w$ est une fonction qui associe à chaque arête dans $e $ un nombre réel (un poids), utile pour représenter des distances, des coûts ou des forces :<br>
triplet $(V, E, w)$ où $w: E \to \mathbb{R}$</p>
</li>
</ol>
<!--Formally, a graph $G $ is modeled as a tuple $(V, E)$ where $V $ is a set of vertices and $E \subseteq V \times V$ is a set of edges. We write $|V| = n$ and $|E| = m$. For a directed graph, an edge $e = (u, v) \in E$ is an ordered pair where $u $ is the source vertex and $V $ is the destination (think Twitter follows, where the relationship has a direction). For an undirected graph, an edge $e = \{u, v\} \in E$ is an unordered pair (think Facebook friendships, where the relationship is mutual). A weighted graph extends this as a triple $(V, E, w)$ where $w: E \to \mathbb{R}$ maps each edge to a real-valued weight, useful for representing distances, costs, strengths…-->
<h2 id="ou-sont-les-graphes"><a class="heading-anchor" href="#ou-sont-les-graphes">Où sont les graphes ?</a></h2>
<p>La puissance du modèle graphe réside dans son universalité. Dès qu’on commence à chercher, les graphes sont partout.</p>
<ul class="list">
<li><strong>Les réseaux sociaux</strong> représentent l’amitié, les abonnements et les interactions comme des arêtes connectant des sommets utilisateurs.<br>
<em>Savoir si Alice connaît Bob par l’intermédiaire d’autres personnes</em><br>
<em>est essentiellement un parcours du graphe pour trouver cette relation.</em></li>
</ul>
<ul class="list">
<li>
<p><strong>Les systèmes de détection de fraude</strong>  modélisent les transactions bancaires entre comptes sous forme de graphes. Les activités frauduleuses génèrent des structures particulières très faciles à repérer telles des cycles ou des amas denses de relations transactions-comptes.<br>
<em>Les relations entre entités révèlent souvent la fraude plus fiablement que les entités elles-mêmes.</em></p>
</li>
<li>
<p><strong>Les chaînes d’approvisionnement et la logistique</strong> utilisent les graphes pour modéliser les dépendances entre fournisseurs, entrepôts et expéditions.</p>
</li>
<li>
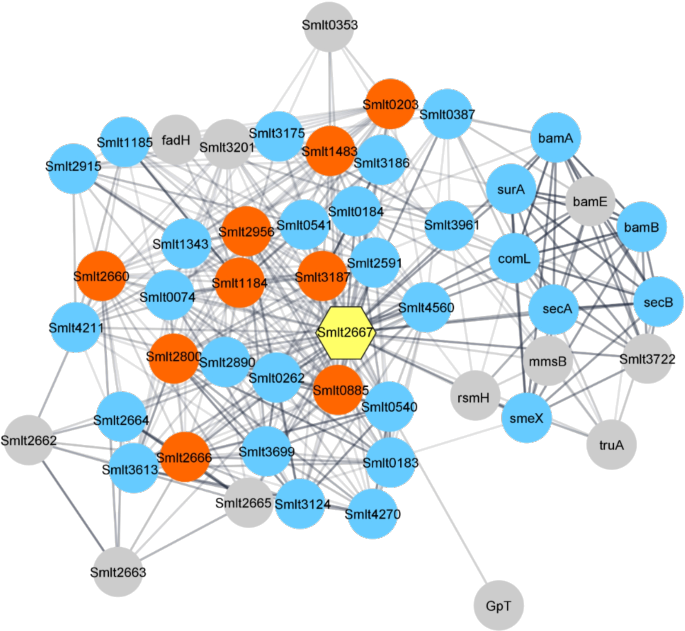
<p>Les biologistes représentent <strong>les réseaux d’interaction protéique et les relations médicament-cible</strong>.<br>
<img src="/assets/images/blog/protein_network_transparent.png" alt="protein_network_transparent" src="/assets/images/blog/protein_network_transparent.png" alt="" width="80%" eleventy:widths="650,960,1400"></p>
</li>
<li>
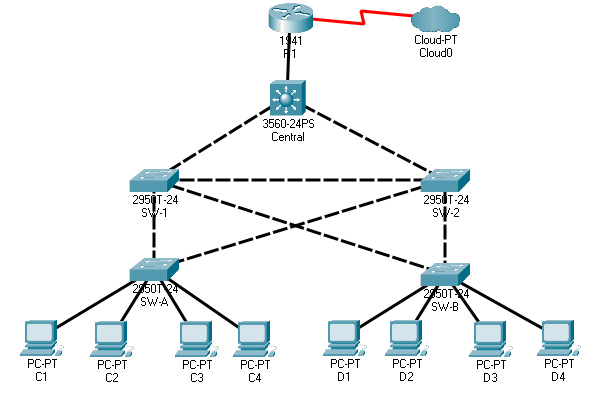
<p><strong>Les réseaux informatiques</strong> utilisent les graphes pour représenter les topologies.</p>
</li>
</ul>
<p><img src="/assets/images/blog/stp_topology_transparent.png" alt="stp_topology_transparent" src="/assets/images/blog/stp_topology_transparent.png" alt="" width="80%" eleventy:widths="650,960,1400"></p>
<ul class="list">
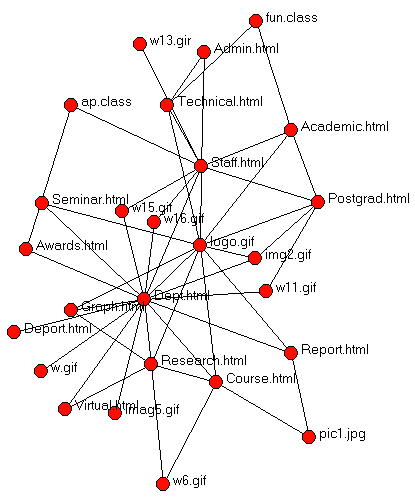
<li><strong>Le Web</strong> est un autre exemple de graphe.<br>
<em>Les pages sont des sommets, les hyperliens sont des arêtes orientées, et le graphe résultant est l’une des structures les plus vastes et les plus étudiées en informatique</em> :</li>
</ul>
<p><img src="/assets/images/blog/web_graph_transparent.png" alt="web_graph_transparent" src="/assets/images/blog/web_graph_transparent.png" alt="" width="80%" eleventy:widths="650,960,1400"></p>
<h2 id="modeliser-comme-un-graphe"><a class="heading-anchor" href="#modeliser-comme-un-graphe">Modéliser comme un graphe</a></h2>
<p>Ce que partagent les exemples de domaines ci-dessus sont des <strong>propriétés</strong> qui font du <strong>graphe</strong> une solution intuitive pour nous, êtres humains. Les relations sont aussi importantes que les entités elles-mêmes.<br>
Le schéma est souvent irrégulier ou évolutif. Les <strong>requêtes</strong> suivent fréquemment des chaînes de connexions dont la longueur ou la forme n’est pas connue à l’avance.</p>
<p><strong>Les graphes sont également efficaces parce qu’ils sont faciles à raisonner visuellement</strong>. Les êtres humains comprennent mieux les choses avec des exemples, et un graphe rend les relations explicites. Cette clarté visuelle et structurelle se traduit souvent par des modèles de données et des algorithmes plus faciles à expliquer et à questionner.</p>
<p>Le modèle défini au début de cet article, un ensemble de sommets et un ensemble d’arêtes sans donnée attachée, sous-tend une grande partie de la théorie classique des graphes et constitue la base des frameworks de traitement de graphes et des systèmes de gestion de bases de données graphe. Il est toutefois trop limité pour la plupart des scénarios de bases de données réels, car il ne transporte aucune information au-delà de la structure. Les modèles plus riches utilisés dans les bases de données graphe sont construits sur cette base.</p>
<ul class="list">
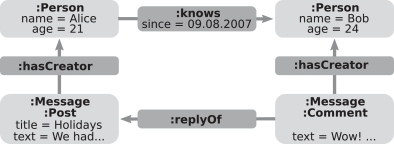
<li>Le <strong>Labeled Property Graph (LPG)</strong> est le modèle conceptuel standard utilisé par la plupart des systèmes de bases de données graphe. Il enrichit le graphe simple par deux mécanismes : les <strong>labels</strong>, qui classent les sommets et les arêtes en types, et les <strong>propriétés</strong>, qui attachent des données arbitraires de type clé-valeur aux sommets et aux arêtes individuels.<br>
Un sommet pourrait avoir le label <code>Person</code> et les propriétés <code>name='Alice'</code> et <code>age=21</code>.<br>
Une arête pourrait avoir le label <code>KNOWS</code> et la propriété <code>since = &quot;09.08.2007&quot;</code>.</li>
</ul>
<p><a href="https://dl.acm.org/doi/10.1145/3604932#sec-3-3-2" target="_blank" rel="noopener"><img src="/assets/images/blog/csur-2022-0455-f02.png" alt="Exemple de Labeled Property Graph, adapté de Besta et al." src="/assets/images/blog/csur-2022-0455-f02.png" alt="" width="80%" eleventy:widths="650,960,1400"></a></p>
<p>D’autres variantes du LPG sont implémentées par d’autres systèmes avec de légères extensions ou restrictions ; par exemple, <a href="https://neo4j.com/" target="_blank" rel="noopener">Neo4j</a> prend en charge un nombre arbitraire de labels par sommet mais limite les arêtes à exactement un label.</p>
<ul class="list">
<li>Le <strong>Resource Description Framework (RDF)</strong> adopte une approche différente. Le RDF représente l’information comme des collections de triplets sujet, prédicat, objet $(s, p, o)$.<br>
Si les systèmes basés sur le RDF constituent une part significative du paysage des bases de données graphe, ils suivent un modèle de données différent du LPG et <strong>sont hors du cadre de cette série</strong>. Nous le mentionnons uniquement pour le contexte, cette série d’articles étant centrée sur les bases de données graphe de type “labeled property graph”.</li>
</ul>
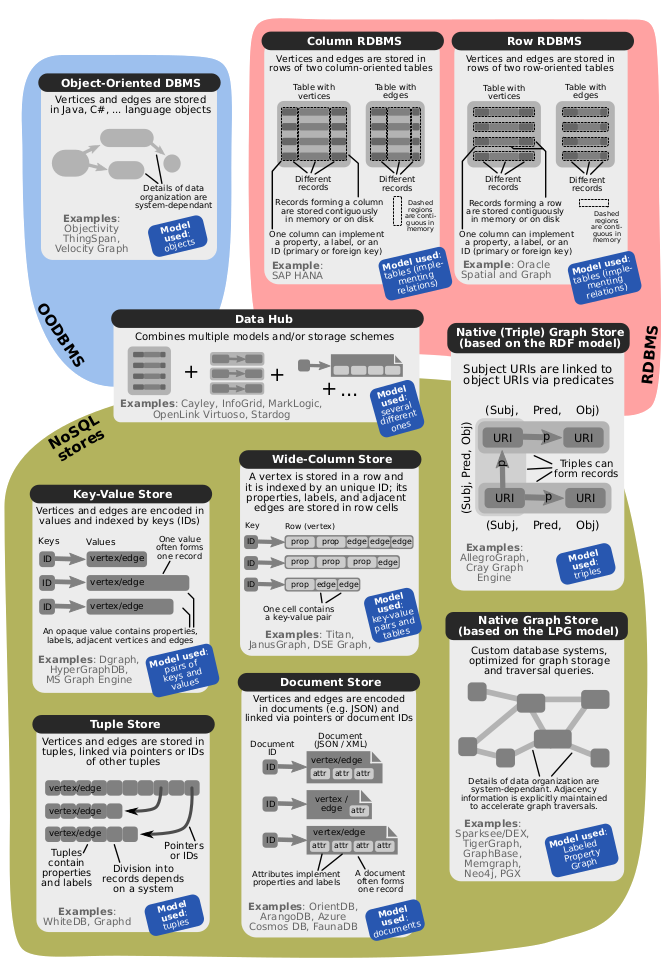
<h2 id="les-nombreuses-formes-des-bases-de-donnees-graphe"><a class="heading-anchor" href="#les-nombreuses-formes-des-bases-de-donnees-graphe">Les nombreuses formes des bases de données graphe</a></h2>
<p>Le paysage des bases de données graphe est hétérogène. Les systèmes diffèrent fondamentalement dans la manière dont ils stockent les graphes, les modèles de données qu’ils supportent et les langages de requête qu’ils exposent.</p>
<p><a href="https://dl.acm.org/doi/10.1145/3604932#sec-5" target="_blank" rel="noopener"><img src="/assets/images/blog/graph_db_models_transparent.png" alt="Aperçu des différents backends de stockage graphe" src="/assets/images/blog/graph_db_models_transparent.png" alt="" width="80%" eleventy:widths="650,960,1400"></a></p>
<p><strong>Les bases de données graphe natives</strong> sont conçues de A à Z autour du modèle graphe. Leurs schémas de stockage et leurs moteurs de requête sont pensés avec les schémas d’accès aux graphes comme préoccupation principale : elles visent à « suivre les pointeurs », ou à accéder à l’adjacence directement, de sorte que la navigation « ne devienne pas un JOIN ».<br>
Neo4j en est l’exemple le plus marquant. Pendant longtemps, son moteur de stockage utilisait des enregistrements de taille fixe avec des pointeurs directs entre eux, et c’était essentiellement ainsi que les gens décrivaient le stockage graphe natif.<br>
Après une quinzaine d’années, en 2024, Neo4j a introduit un format de blocs qui co-localise les données apparentées dans des blocs de longueur variable à l’intérieur de pages <sup class="footnote-ref"><a href="#fn1" id="fnref1">[1]</a></sup>. Bien que cette prise de conscience tardive soit un progrès, elle implique que la description « natif équivaut à suivre des pointeurs » n’est plus tout à fait exacte.<br>
La définition utile devrait donc être comportementale, c’est-à-dire que les systèmes natifs tentent de rendre l’accès à l’adjacence direct, que ce soit par des pointeurs, des blocs co-localisés ou d’autres schémas spécifiques aux graphes.</p>
<p><strong>Les bases de données graphe non natives</strong> reprennent un backend mature existant ; une base relationnelle, orientée document ou clé-valeur, et construisent des capacités graphe par-dessus <sup class="footnote-ref"><a href="#fn2" id="fnref2">[2]</a></sup>. Les deux classes sont des bases de données graphe au sens où elles stockent, interrogent et gèrent des données de type graphe, mais leurs composants internes sont fondamentalement différents, ce qui implique que des optimisations spécifiques aux graphes sont disponibles, adapatées au backend.<br>
En pratique, la différence porte davantage sur l’endroit où l’effort d’ingénierie est investi : par exemple, les systèmes non natifs héritent de décennies de travail en contrôle de concurrence, indexation, optimisation des requêtes et bien d’autres composants de SGBD.</p>
<hr>
<p><strong>Une étude</strong> d’une centaine de systèmes de bases de données graphe révèle qu’environ 66 % sont non natifs. La répartition des modèles de données sous-jacents se décompose comme suit : 34 % de stockage graphe natif, 24 % de bases de données relationnelles, 24 % de stockages clé-valeur ou à colonnes larges, et 18 % de stockages orientés document. Cela a du sens : on souhaite rendre un SGBD existant capable de supporter les requêtes graphe si possible, offrant ainsi aux utilisateurs la meilleure interface possible.</p>
<p>C’est précisément à cet endroit que PostgreSQL entre en jeu. En tant que base de données relationnelle mature, elle représente une part massive de cet écosystème non natif à travers des extensions et de nouvelles normes SQL.</p>
<!-- *That is enough vocabulary to start. In the next post, we look at SQL/PGQ in PostgreSQL: what it does, how it is implemented, and where it stands today.* -->
<h2 id="points-cles"><a class="heading-anchor" href="#points-cles">Points clés</a></h2>
<p>Avant de passer à l’implémentation technique, rappelons les concepts fondamentaux de cette introduction :</p>
<ul class="list">
<li><strong>Les graphes sont universels :</strong> Au fond, ils ne sont que des sommets (nœuds) et des arêtes (relations), ce qui les rend idéaux pour des données complexes et interconnectées comme les réseaux sociaux ou les réseaux de fraude.</li>
<li><strong>Le LPG est la norme de l’industrie :</strong> Le modèle Labeled Property Graph étend les graphes simples en permettant d’attacher des labels et des propriétés clé-valeur aux nœuds et aux arêtes.</li>
<li><strong>Natif vs. non-natif est une distinction comportementale :</strong> Les bases de données natives (comme Neo4j) optimisent l’accès direct à l’adjacence, tandis que les bases non natives exploitent des moteurs de niveau entreprise existants (relationnels, orientés document) pour traiter les charges de travail graphe.</li>
<li><strong>Le paysage est hybride :</strong> Plus de 66 % des solutions de bases de données graphe sont construites sur des backends non graphe, prouvant qu’il n’est pas toujours nécessaire de déployer une nouvelle base de données native pour interroger des structures de type graphe.</li>
</ul>
<h2 id="et-maintenant"><a class="heading-anchor" href="#et-maintenant">Et maintenant ?</a></h2>
<p>Maintenant que nous avons posé le vocabulaire de base, nous pouvons explorer comment intégrer ce modèle dans le monde relationnel. Dans <a href="/fr/blog/postgresql-comme-bdd-graphe-part-1/">la <strong>partie 1</strong></a>, nous plongerons directement dans <strong>SQL/PGQ dans PostgreSQL</strong> : ce que cette nouvelle norme apporte, comment elle est implémentée en interne, et les limitations actuelles.</p>
<!-- 👉 **Quelle est votre stack actuelle ?** Utilisez-vous une base de données graphe native, ou souhaitez-vous étendre votre base de données relationnelle existante ? Dites-le moi dans les commentaires ci-dessous ! -->
<hr class="footnotes-sep">
<section class="footnotes">
<ol class="footnotes-list">
<li id="fn1" class="footnote-item"><p><a href="https://neo4j.com/docs/operations-manual/current/database-internals/store-formats/" target="_blank" rel="noopener">Neo4j store formats</a> <a href="#fnref1" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn2" class="footnote-item"><p>Plusieurs images empruntées à <a href="https://dl.acm.org/doi/10.1145/3604932" target="_blank" rel="noopener">Besta, M. et al. (2023). Demystifying Graph Databases: Analysis and Taxonomy of Data Organization, System Designs, and Graph Queries. <em>ACM Computing Surveys</em>, 56(2), Art. 31.</a> <a href="#fnref2" class="footnote-backref">↩︎</a></p>
</li>
</ol>
</section>
 ]]></content>
			<author>
				<name>Ayoub Kazar</name>
			</author>
    </entry>
    <entry>
      <title>IvorySQL 5.0+ : un tournant pour les transitions Oracle vers PostgreSQL</title>
      <link href="https://www.data-bene.io/fr/blog/ivorysql-5/" />
      <updated>2026-01-27T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/ivorysql-5/</id>
     <content type="html"><![CDATA[ <p>IvorySQL : « un PostgreSQL avancé, complet, open source, compatible Oracle, avec un engagement ferme de rester toujours 100% compatible et un remplacement direct de la dernière version de PostgreSQL. » (<a href="https://github.com/IvorySQL/IvorySQL" rel="noopener">GitHub</a>)</p>
<p>C’est aussi le moteur préféré de notre équipe pour traduire à la fois le SQL étranger et les applications étrangères pour PostgreSQL ! Nous croyons en les transitions, pas les migrations — un déplacement progressif de l’ancien moteur de base de données vers le nouveau, spécifiquement pour réduire les risques et optimiser les résultats. Utiliser un projet comme celui-ci fait toute la différence pour atteindre ces deux objectifs.</p>
<p>La dernière version majeure est sortie il y a un peu de temps, mais nous sommes toujours enthousiastes quant à ce qui est nouveau et nous avons tenu à le partager.</p>
<h2 id="nouveautes"><a class="heading-anchor" href="#nouveautes">Nouveautés</a></h2>
<p>La version 5.0 (<a href="https://github.com/IvorySQL/IvorySQL/releases/tag/IvorySQL_5.0" rel="noopener">notes de version</a>) est sortie le 25 novembre 2025 et une version mineure a déjà été publiée depuis (<a href="https://github.com/IvorySQL/IvorySQL/releases/tag/IvorySQL_5.1" rel="noopener">notes de version 5.1</a>) le 18 décembre 2025. Ces éditions du projet sont le résultat direct des efforts massifs de l’équipe IvorySQL pour fournir de nombreuses améliorations de qualité ainsi que pour implémenter la compatibilité avec PostgreSQL 18.</p>
<p>IvorySQL 5 a apporté de nombreux changements nécessaires, notamment :</p>
<ul class="list">
<li><strong>PLiSQL</strong> — un sous-ensemble compatible d’Oracle PL/SQL</li>
<li><strong>Support des paquets compatibles Oracle</strong></li>
<li><strong>Support des séquences style Oracle</strong></li>
<li>les améliorations de v5.0 telles que <strong>ROWID</strong>, <strong>%TYPE</strong>, <strong>%ROWTYPE</strong> et <strong>les sous-fonctions imbriquées</strong></li>
</ul>
<p>En particulier, nous apprécions beaucoup les améliorations fonctionnelles.</p>
<p>Par exemple, IvorySQL dispose désormais d’un <strong>meilleur traitement des valeurs NULL</strong>, où NULL est désormais traité comme une chaîne vide en mode compatible (correspondant au comportement Oracle) pour éviter des bugs lors de la migration. Ainsi, dans des situations telles que <code>SELECT CONCAT('a' || NULL)</code>, IvorySQL retournera désormais <code>'a'</code> au lieu de suivre le comportement de PostgreSQL qui retournerait <code>NULL</code>.</p>
<p>Une amélioration que nous apprécions particulièrement est qu’il est désormais possible <strong>d’imbriquer des fonctions et des procédures</strong>. Les fonctions peuvent être intégrées dans d’autres fonctions (à la manière des paquets Oracle, mais plus simplement, en utilisant uniquement des méthodes privées). Cela permet d’organiser une logique complexe en un seul endroit.</p>
<p>Dans le même ordre d’idées, le support a également été ajouté pour <code>DO [ LANGUAGE lang_name ] code [USING IN | OUT | IN OUT, ...]</code>.</p>
<h2 id="lessayer"><a class="heading-anchor" href="#lessayer">L’essayer</a></h2>
<p>Actuellement, nous intégrons des applications allant de quelques paquets, procédures et fonctions (environ 10 à 50 objets) à des chargements de données massifs incluant environ 50 000 objets (plus de 10 000 procédures et des centaines de paquets).</p>
<p>Bien que de nombreuses fonctionnalités devront encore être ajoutées avec le temps, cela réduit considérablement l’effort nécessaire pour achever avec succès la transition d’Oracle vers PostgreSQL.</p>
<p>Si vous envisagez de le tester vous-même, il existe une pléthore d’options pour commencer (y compris la compilation depuis la source, l’utilisation de conteneurs, etc.)… et même une compilation WASM ! En particulier, cela permet d’exécuter IvorySQL directement dans le navigateur sans avoir à l’installer localement ; c’est très pratique pour examiner le support de syntaxe et faire le premier pas vers le monde de PostgreSQL.</p>
<p>Vous pouvez déployer le projet IvorySQL-WASM localement en quelques étapes, en suivant <a href="https://www.ivorysql.org/blog/ivorysql-wasm/" rel="noopener">le billet de blog publié par IvorySQL</a> sur le sujet.</p>
<p>Sinon, vous pouvez <a href="https://trial.ivorysql.org/" rel="noopener">essayer le WASM hébergé</a> sur le site web d’IvorySQL.</p>
<h2 id="et-la-suite"><a class="heading-anchor" href="#et-la-suite">Et la suite ?</a></h2>
<p>Vous souhaitez en apprendre davantage sur l’utilisation d’IvorySQL ? Restez à l’affût des webinaires enregistrés sur leur site web (<a href="https://www.ivorysql.org/webinars-page" rel="noopener">à venir !</a>), ou <a href="https://www.youtube.com/@ivorysql" rel="noopener">consultez les enregistrements</a> de la conférence HOW2025 à Jinan, en Chine, en attendant.</p>
<p><a href="https://ivorysql.io/" rel="noopener">La prochaine conférence à Jinan</a> est déjà prévue, du 26 au 28 avril ! (Au passage, <a href="https://sessionize.com/how2026" rel="noopener">l’appel à contributions est ouvert</a> jusqu’au 27 février 2026.)</p>
<p>Notre équipe est heureuse d’employer des contributeurs au projet IvorySQL. Certains de nos membres (Cédric Villemain, Yasir Hussain Shah) ont été reconnus dans les notes de version de 5.0 et 5.1 — et nous avons d’autres ajouts prévus. Pour la prochaine version, nous avons prévu des développements passionnants, notamment :</p>
<ul class="list">
<li>la syntaxe de contrainte <code>ENABLE/DISABLE</code></li>
<li>l’ajout du paquet <code>UTL_FILE</code></li>
<li>le corps de <code>CREATE TRIGGER</code> style Oracle (sans avoir besoin de créer une fonction au préalable)</li>
<li>le support de l’opérateur de jointure legacy d’Oracle <code>(+)</code></li>
</ul>
<p>Nous avons hâte de voir les résultats du travail communautaire en cours pour la prochaine version. De nombreuses fonctionnalités excellentes sont activement ajoutées ; par exemple, récemment, un nouveau contributeur au projet, Rophy Tsai, a ajouté les paquets <code>DBMS_OUTPUT</code> et <code>DBMS_UTILITY</code> : des éléments largement utilisés dans les bases de code SQL basées sur Oracle. Ils ont récemment été fusionnés dans la branche principale d’IvorySQL et seront probablement inclus dans la prochaine version mineure ou majeure.</p>
<p>Pour ceux qui souhaitent passer à PostgreSQL ou l’explorer sans modifications importantes de leur logique de base de données et de leurs applications existantes, IvorySQL (en particulier v5.x) offre une solution pratique. Une migration directe vers PostgreSQL pourrait, dans certains cas, nécessiter des changements importants tant au niveau des objets de base de données qu’au niveau du code applicatif. IvorySQL aide à combler cet écart, permettant une adoption plus fluide de PostgreSQL avec une plus grande compatibilité.</p>
<h2 id="ressources-complementaires"><a class="heading-anchor" href="#ressources-complementaires">Ressources complémentaires</a></h2>
<ul class="list">
<li><a href="https://www.postgresql.org/about/news/ivorysql-50-released-major-oracle-compatibility-expansion-on-postgresql-180-foundation-3180/" rel="noopener">Annonce PostgreSQL.org pour IvorySQL 5</a></li>
<li><a href="https://github.com/orgs/IvorySQL/projects/19" rel="noopener">Feuille de route d’IvorySQL 5.0 sur GitHub</a></li>
</ul>
 ]]></content>
			<author>
				<name>Yasir Hussain Shah</name>
			</author>
    </entry>
    <entry>
      <title>L'optimisation des bases de données et l'importance de réduire la pollution numérique mondiale</title>
      <link href="https://www.data-bene.io/fr/blog/optimisation-base-de-donnees-et-pollution-mondiale/" />
      <updated>2026-01-19T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/optimisation-base-de-donnees-et-pollution-mondiale/</id>
     <content type="html"><![CDATA[ <p>Je repensais au <a href="https://pgibz.io/" rel="noopener">Postgres Ibiza (PGIBZ)</a> qui a eu lieu il y a quelques mois… Et pas seulement parce que la chaleur et le soleil d’Ibiza me manquent, l’hiver étant arrivé à Cognac ! Non, je me souvenais que l’île portait encore les traces des récentes inondations, même si les habitants s’activaient pour effacer les dégâts. Les dernières nouvelles des Caraïbes et d’Asie m’ont fait réaliser qu’Ibiza avait, toutes proportions gardées, été plutôt chanceuse.</p>
<p>Cet événement fait partie d’une succession d’évènements climatiques exceptionnels et de records battus aux États-Unis, en Europe et en Asie ces dernières années. La semaine dernière encore, au moment de la rédaction de cet article, l’État de Washington (États-Unis) a connu des inondations historiques qui ont causé des dégâts considérables : plus de 11 millards de m³ d’eau se sont déversés sur l’État en dix jours. Ces pluies torrentielles devraient se poursuivre sur toute la côte ouest américaine jusqu’à la fin de l’année.</p>
<p>J’ignore si ce contexte a influencé la réception de mon intervention lors de la conférence, et je suis reconnaissante qu’elle ait non seulement été entendue, mais aussi écoutée, et même qu’elle ait suscité des réflexions et des discussions. Je dois avouer que je ne m’y attendais pas.</p>
<p>Je fais partie de ceux qui pensent que les défis environnementaux sont sur le point de transformer radicalement nos sociétés à tous les niveaux et à l’échelle planétaire, à mesure que les ressources se raréfient et se redistribuent. Je me demande si d’autres se posent la même question : « À quoi bon un salaire confortable si les pommes de terre ne poussent plus ? » Maslow a clairement démontré qu’il est moins important d’être riche que de se nourrir. Pourtant, comme nous le savons, l’environnement n’est toujours pas une priorité absolue, malgré tout ce que nous voyons arriver.</p>
<p>Il me semblait donc logique d’aborder ce sujet lors d’une conférence PostgreSQL, car il devrait être discuté partout. Mais étais-je certaine de trouver un public réceptif ? Absolument pas !</p>
<p>Je me sentais un peu mal à l’aise – comme souvent lors de conférences vu mon manque de backgroud technique – à l’idée d’emmener le public sur un terrain qui n’était pas forcément celui qu’il recherchait. J’espérais ne pas ennuyer, déranger, ni même agacer. Mais dès les premières diapositives, j’ai vu que les gens prenaient des photos des données que je présentais, certains acquiesçaient, d’autres découvraient ces chiffres pour la première fois et haussaient un sourcil. Et quand j’ai fait le lien avec nos activités quotidiennes et l’impact de la pollution numérique que nous produisons, au lieu de susciter l’indifférence ou la désapprobation, j’ai eu droit à des regards intéressés, du genre « pourquoi pas ! ».</p>
<h2 id="alors-quelle-pollution-numerique-produisons-nous"><a class="heading-anchor" href="#alors-quelle-pollution-numerique-produisons-nous">Alors quelle pollution numérique produisons-nous ?</a></h2>
<p>Selon Greenpeace, la pollution numérique désigne toutes les formes de pollution causées par le secteur informatique : émissions de gaz à effet de serre, contamination chimique, érosion de la biodiversité et production de déchets électroniques.</p>
<p>Oui, des solutions sont conçues pour que les data centers utilisent la chaleur qu’ils produisent afin de chauffer les bureaux ou les habitations avoisinantes, ce qui fonctionne en hiver. Des projets comme celui d’Amazon à Tallaght constituent « le premier réseau de chauffage urbain à grande échelle de ce type en Irlande », contribuant à « réduire considérablement les émissions dans la région de près de 1 500 tonnes de CO2/an, faisant de Tallaght un chef de file en matière d’action énergétique locale » (<a href="https://www.seai.ie/case-studies/tallaght-district-heating" rel="noopener">source</a>).</p>
<p>Cependant, la croissance du nombre d’utilisateurs équipés d’au moins un terminal connecté (notamment dans les pays en développement), l’augmentation du ratio terminaux connectés/individu (de 2,1 en 2015 à 3,3 en 2020 en moyenne dans le monde), la hausse du trafic vidéo, conjuguée à la part croissante des images en HD et UHD, et le passage à la consommation à la demande (streaming, VOD, cloud gaming) ont entraîné une explosion du trafic sur les réseaux (plus de 25 % par an) et dans les data centers (+35 % par an). Cette croissance est plus rapide que les gains d’efficacité énergétique des équipements, des réseaux et des centres de données. Ces prévisions de trafic sont d’ailleurs régulièrement revues à la hausse.</p>
<p>Bien que le nombre d’appareils « standard » (hors objets connectés) ait augmenté de manière significative entre 2000 et 2015, il se stabilise entre 2015 et 2025 car le marché est saturé.</p>
<p>Bien que la masse par utilisateur diminue légèrement, passant de 63 kg d’émissions de CO2 à 58 kg entre 2010 et 2025, la masse totale (équipements utilisateurs, réseaux, data centers) a été multipliée par plus de 2,5 en 15 ans : elle passe de 128 millions de tonnes en 2010 à 317 millions de tonnes en 2025.</p>
<p>Ceci explique la pression exercée sur les matières premières, notamment les « minerais de conflit » et autres terres rares.</p>
<h2 id="la-cle-dun-monde-plus-vert"><a class="heading-anchor" href="#la-cle-dun-monde-plus-vert">La clé d’un monde plus vert</a></h2>
<p>L’optimisation des performances des bases de données ne se limite pas à une amélioration des coûts et de la vitesse. En optimisant une requête, on économise l’énergie superflue utilisée pour les opérations de lecture/écriture et les déplacements inutiles sur le disque. D’autres pratiques responsables, qui permettent d’exploiter intelligemment la puissance de la technologie, contribuent non seulement à une meilleure efficacité technique, mais aussi, souvent inconsciemment, à la protection de l’environnement.</p>
<p>Par exemple, certaines actions que nous entreprenons régulièrement et qui ont également un impact positif sur notre planète incluent :</p>
<ul class="list">
<li>l’optimisation des requêtes</li>
<li>l’optimisation des index</li>
<li>la réalisation d’audits de performance pour identifier les goulots d’étranglement et les problèmes</li>
<li>le choix de technologies moins énergivores</li>
<li>la réduction de l’empreinte des données (suppression des données redondantes, corrompues ou inutiles)</li>
<li>l’optimisation de l’infrastructure de stockage et de la puissance de calcul afin de réduire la consommation d’énergie</li>
</ul>
<p>Nous nous devons de considérer la sobriété numérique comme la clé de voute pour un code plus écologique et nous pouvons décider d’intégrer ce paramètre dans notre façon de travailler au quotidien et dans la façon dont nous concevons, gérons et développons des solutions de bases de données qui minimisent autant que possible notre empreinte environnementale.</p>
<p>Une remarque supplémentaire : l’IA, en particulier, entraîne une forte augmentation de la consommation d’eau, des émissions de CO2 et des déchets électroniques (l’entraînement des modèles d’IA est l’une des tâches les plus gourmandes en ressources au monde !). Dans un monde où l’IA est devenue omniprésente dans les applications et les pratiques de programmation quotidiennes, il est crucial d’utiliser ces technologies avec discernement afin de s’assurer qu’elles constituent réellement la meilleure solution au problème posé. L’IA est-elle vraiment la solution la plus appropriée au problème que vous avez en tête ? Ou envisagez-vous son utilisation simplement parce qu’elle est plus facile à mettre en œuvre qu’une solution plus complexe techniquement ?</p>
<h2 id="cest-a-vous"><a class="heading-anchor" href="#cest-a-vous">C’est à Vous !</a></h2>
<p>Je propose cette perspective sur nos tâches quotidiennes en espérant qu’elle soit intéressante. On se plaint parfois de ne pas trouver de sens à ce qu’on fait ; eh bien voilà !</p>
<p><strong>Un petit message de notre équipe marketing Data Bene :</strong> Notre équipe d’ingénieurs PostgreSQL expérimentés peut vous aider à améliorer votre efficacité énergétique, à optimiser vos bases de données et à adopter des pratiques de codage responsables. Vous bénéficierez ainsi d’avantages directs : des opérations de base de données plus rapides, une consommation de ressources réduite, des coûts moindres et un impact environnemental moindre. Curieux d’en savoir plus sur nos services ? <a href="https://data-bene.io/en/#contact" rel="noopener">Contactez-nous ! Nous serions ravis d’en discuter.</a></p>
 ]]></content>
			<author>
				<name>Catherine Bouxin</name>
			</author>
    </entry>
    <entry>
      <title>Open Source Experience 2025</title>
      <link href="https://www.data-bene.io/fr/blog/open-source-experience-2025/" />
      <updated>2026-01-03T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/open-source-experience-2025/</id>
     <content type="html"><![CDATA[ <p>L’édition 2025 de l’<a href="https://www.opensource-experience.com/" rel="noopener">Open Source Experience (OSXP)</a> s’est tenue les 10 et 11 décembre sous le thème « Open Source, clé de l’autonomie stratégique de l’Europe ». L’accent portait, comme vous l’imaginez, entièrement sur la redéfinition de l’avenir numérique européen comme étant mené par les innovations open source à travers toutes les technologies (incluant la gestion des données, le cloud et la cybersécurité). Cette année, de nombreuses conférences se sont largement concentrées sur l’intersection entre l’open source et les technologies d’IA (en accord avec l’accent que l’industrie technologique a mis sur l’IA en général, en 2025).</p>
<h2 id="levenement"><a class="heading-anchor" href="#levenement">L’événement</a></h2>
<p>L’événement a duré 2 jours avec 90 exposants, 130 sessions, 150 intervenants et plus de 4 000 participants - une conférence de très grande envergure, située à la Cité des Sciences et de l’Industrie à Paris.</p>
<p>Ce lieu particulier était plus petit que celui de l’année dernière (Le Palais des Congrès) et les salles dans lesquelles nous sommes allés étaient toutes pleines en raison de leur petite taille (environ 20 ou 30 places tout au plus).</p>
<h2 id="le-format-des-conferences"><a class="heading-anchor" href="#le-format-des-conferences">Le format des conférences</a></h2>
<p>Les présentations ont été données en anglais et en français. Fait intéressant, il n’y avait pas de “salles silencieuses” cette année (où des écouteurs sont fournis à chaque participant). Tout le monde n’a pas apprécié ce format l’année dernière, mais c’était utile pour suivre deux conférences, ou basculer entre elles en fonction du contenu ou des questions.</p>
<p>Deux membres de notre équipe étaient présents et ont pu découvrir divers exposants et salles dédiées aux conférences répartis sur trois étages. Ces dernières duraient 20 minutes et bien que trop courtes pour entrer dans les détails, ce format était intéressant pour découvrir les nouvelles technologies et attiser notre curiosité d’un coup d’œil.</p>
<h2 id="le-contenu-des-conferences"><a class="heading-anchor" href="#le-contenu-des-conferences">Le contenu des conférences</a></h2>
<p>Il y avait six pistes dans lesquelles les conférences étaient catégorisées :</p>
<ul class="list">
<li>Modèles économiques et gouvernance pour des stratégies ouvertes durables</li>
<li>Intelligence artificielle et calcul scientifique pour l’analyse des données</li>
<li>Architecture cloud et virtualisation pour un avenir autonome</li>
<li>Développement - l’innovation logicielle en action</li>
<li>Cybersécurité et chaîne de production logicielle : l’Open Source comme fondement de confiance</li>
<li>Outils collaboratifs et applications métier : reprendre l’autonomie numérique</li>
</ul>
<p>Nous avons trouvé le sujet des solutions open source dans le secteur public le plus intéressant. En particulier, il était facile de voir que notre dépendance en tant que société mondiale aux cinq grandes entreprises technologiques (GAFAM : Google, Apple, Facebook, Amazon et Microsoft) a considérablement augmenté ces dernières années. Les logiciels open source sont une solution directe pour protéger notre droit collectif à la vie privée à l’ère numérique, ce qui explique exactement pourquoi des conférences comme celle-ci sont si importantes pour la découverte d’alternatives OSS et l’innovation qui conduit à un développement ultérieur dans ce secteur.</p>
<h2 id="la-participation"><a class="heading-anchor" href="#la-participation">La participation</a></h2>
<p>La fréquentation a été particulièrement importante dès le premier jour. Nous avons été ravis d’avoir l’occasion d’échanger en “présentiel”, et de rencontrer nos partenaires, en particulier <a href="https://www.ow2.org/" rel="noopener">OW2</a> qui organise également un évènement Open Source, annuel, en Juin. (L’appel à conférence est ouvert jusqu’au 14 février 2026 - consultez l’appel à propositions d’OW2Con’26 <a href="https://www.ow2con.org/view/2026/Call_For_Presentations" rel="noopener">ici</a>.)</p>
<p>L’évènement étant entièrement sur les technologies open source, nous avons pu discuter avec les nombreux participants de sujets tels que le support PostgreSQL, les difficultés et impacts organisationnel pour les entreprises souhaitant innover et adopter PostgreSQL, avec en trame de fond la demande du marché pour se libérer des contraintes de licence des éditeurs logiciels.</p>
<p>Nous avons également eu le plaisir de rencontrer des acteurs de l’innovation “hardware” open-source, en résonnance avec notre propre R&amp;D sur les processeurs RISC-V.</p>
<p>De nombreux projets libres et open source étaient représentés. Quelques exemples incluent <a href="https://nextcloud.com" rel="noopener">Nextcloud</a> (une plateforme de collaboration cloud auto-hébergée que nous utilisons personnellement pour l’hébergement ici chez Data Bene), qui est une alternative à Nextcloud), et <a href="https://opentalk.eu/en" rel="noopener">OpenTalk</a>, une solution de visioconférence conforme au RGPD, opérant dans des centres de données allemands.</p>
<h2 id="en-conclusion"><a class="heading-anchor" href="#en-conclusion">En conclusion</a></h2>
<p>L’événement était réussi et bien organisé. La seule chose qui aurait amélioré l’expérience aurait été des présentations plus longues pour explorer les divers sujets abordés plus en profondeur. Si vous souhaitez découvrir de nouveaux projets open source, notez que l’événement est également une très bonne opportunité pour échanger en toute liberté sur ces sujets.</p>
<p>Les rediffusions vidéo pour 2025 n’ont pas encore été publiées, mais les enregistrements des conférences passées peuvent être trouvés sur le <a href="https://www.opensource-experience.com/en/video-replays" rel="noopener">site officiel, ici</a>.</p>
<p>Dans l’ensemble, nous avons beaucoup apprécié l’événement et espérons y assister l’année prochaine !</p>
 ]]></content>
			<author>
				<name>Grégory Tiram</name>
			</author>
    </entry>
    <entry>
      <title>PGIBZ 2025 : un événement pour la communauté Postgres à Ibiza</title>
      <link href="https://www.data-bene.io/fr/blog/postgres-ibiza-2025/" />
      <updated>2025-12-11T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/postgres-ibiza-2025/</id>
     <content type="html"><![CDATA[ <p><a href="https://pgibz.io/" rel="noopener">Postgres Ibiza (PGIBZ)</a> : une conférence open source conçue pour rassembler des personnes passionnées par PostgreSQL à Ibiza, un lieu détendu propice à des discussions fraîches et innovantes. Un événement international organisé par l’association à but non lucratif PostgreSQL España.</p>
<p>C’était la première fois que l’équipe Data Bene assistait à cet événement, et nous sommes heureux de partager qu’il s’est avéré très positif.</p>
<h2 id="la-conference"><a class="heading-anchor" href="#la-conference">La conférence</a></h2>
<h3 id="lieu-et-lieu-de-levenement"><a class="heading-anchor" href="#lieu-et-lieu-de-levenement">Lieu et lieu de l’événement</a></h3>
<p>Comme son nom l’indique, cette conférence a lieu sur l’île méditerranéenne d’Ibiza. Pour ceux qui le connaissent moins, le site touristique officiel propose <a href="https://ibiza.travel/en/know-ibiza/where-we-are/" rel="noopener">un bon aperçu</a> auquel vous pouvez vous référer. Et il va sans dire que ce <a href="https://whc.unesco.org/en/list/417" rel="noopener">site classé au patrimoine mondial de l’UNESCO</a> offre des attractions incroyables en dehors même de la conférence. Combiné à un potentiel long trajet en avion, il est fortement recommandé de prévoir un jour ou deux supplémentaires (ou plus) pour explorer l’île et profiter de l’expérience locale.</p>
<p>L’événement lui-même est hébergé au <a href="https://www.palaciocongresosibiza.com/ibiza-congress-center/#main_english" rel="noopener">Palacio de Congresos de Ibiza</a> ; un centre de congrès sur deux niveaux avec de multiples salles et un service de restauration. Bien qu’il soit situé en dehors de la capitale, le lieu est accessible en voiture en un temps raisonnable (~15 minutes). À noter également que le centre est à distance de marche de nombreux hôtels, restaurants et d’une plage ! Nous avons séjourné à l’<a href="https://www.hoteltrestorresibiza.com/" rel="noopener">Hôtel Tres Torres</a>, que nous pouvons recommander, bien que, pour être honnête, il soit difficile de faire un mauvais choix, surtout après un peu de recherche préalable.</p>
<p>En bref, pour ce qui est des activités annexes, notre recommandation principale serait de visiter la ville d’Ibiza. Vous y trouverez une quantité surprenante de commerces, de restaurants et de visites. Ajoutez à cela une promenade dans le quartier historique et vous avez une expérience plutôt mémorable.</p>
<h3 id="participation"><a class="heading-anchor" href="#participation">Participation</a></h3>
<p>PGIBZ de cette année a accueilli environ 30 à 40 participants venus du monde entier, dont la Chine et les États-Unis. Et bien qu’il y ait certes deux côtés à la pièce, je considère cette taille de groupe plutôt comme un point positif. En effet, lors des sessions de questions-réponses après les présentations, ainsi que lors des pauses café, j’ai trouvé les interactions globalement plus engageantes. C’était particulièrement vrai lors des rencontres et retrouvailles avec des membres d’entreprises de petite taille ainsi que des entreprises de dimension globale.</p>
<h2 id="presentations-de-notre-equipe"><a class="heading-anchor" href="#presentations-de-notre-equipe">Présentations de notre équipe</a></h2>
<h3 id="catherine"><a class="heading-anchor" href="#catherine">Catherine</a></h3>
<p>La première des intervenantes Data Bene, et pour la présentation inaugurale de la première journée, était Catherine Bouxin. Sa présentation traitait de l’impact environnemental de la technologie et reflétait la philosophie selon laquelle les sujets importants ne sont pas toujours ceux dont on parle, et qu’ils ne sont souvent même pas considérés comme un problème ! En effet, Catherine a cadré cette conversation principalement comme un rappel de la responsabilité que nous partageons en tant que membres de la communauté PostgreSQL. De nombreuses inventions passionnantes ont vu le jour récemment, certaines avec des implications de transformation de la société, mais nous ne pouvons ignorer l’intensité des ressources que beaucoup d’entre elles nécessitent.</p>
<p>Nous souscrivons pleinement au message de Catherine sur la contribution à un avenir plus vert et la prise de décisions réfléchies à cette fin, et nous sommes ravis que cela ait été très bien accueilli par le public.</p>
<h3 id="cedric"><a class="heading-anchor" href="#cedric">Cédric</a></h3>
<p>Le deuxième jour, notre fondateur et PDG, Cédric Villemain, a présenté les points forts statistiques de la grande version 18 de PostgreSQL (<a href="https://www.postgresql.org/docs/release/18.0/" rel="noopener">notes officielles liées ici</a>). (Après l’événement, il a créé un billet de blog sur le sujet des statistiques cumulées dans Postgres 18 — <a href="https://www.data-bene.io/en/blog/cumulative-statistics-in-postgresql-18/" rel="noopener">voir ici</a> !) Notre équipe chez Data Bene est fan des statistiques et de la mise en évidence des données, ce qui nous a amenés à créer l’extension PostgreSQL <a href="https://codeberg.org/Data-Bene/StatsMgr" rel="noopener">StatsMgr</a>. <em>Si vous avez raté les informations sur StatsMgr et souhaitez en savoir plus, <a href="https://www.data-bene.io/en/blog/postgres-cafe-expand-monitoring-capabilities-with-statsmgr/" rel="noopener">consultez notre précédent billet de blog et l’épisode de Postgres Café sur le sujet.</a></em></p>
<h3 id="evan"><a class="heading-anchor" href="#evan">Evan</a></h3>
<p>Immédiatement après Cédric, j’ai eu l’opportunité de présenter le développement et la maintenance d’une extension PostgreSQL basée sur Rust (encore au stade très précoce) qui aide à faciliter la transition d’Oracle vers PostgreSQL. Ce projet, nommé <code>pgtap_gen</code>, s’appuie sur le projet existant <a href="https://github.com/theory/pgtap" rel="noopener">pgTAP</a> pour automatiser la création de tests unitaires sur IvorySQL (un PostgreSQL forké à 100 % open source avec des composants analogues à Oracle). J’ai trouvé très encourageant de recevoir les réactions et retours du public. De plus, c’est gratifiant de participer à l’écosystème PostgreSQL, même pour des initiatives de preuve de concept !</p>
<h3 id="frederic"><a class="heading-anchor" href="#frederic">Frédéric</a></h3>
<p>Vers la fin du deuxième jour, Frédéric a prononcé un discours sur les niveaux d’isolation des transactions dans PostgreSQL (que vous aurez peut-être la chance de voir plus tard, car il a soumis la même présentation à pgDay Paris 2026 et PGDay CERN 2026 !). Il a exploré chaque niveau d’isolation de Postgres avec des exemples pratiques, et a expliqué comment tout fonctionne en coulisses pour définir des étapes concrètes permettant de choisir en toute confiance le bon niveau pour le bon contexte. Les participants ont semblé trouver la présentation intéressante et instructive, nous pourrions donc voir d’autres contenus sur ce sujet et des sujets similaires pour aider ceux qui ont raté l’opportunité d’apprendre sur ce thème.</p>
<h2 id="conclusions"><a class="heading-anchor" href="#conclusions">Conclusions</a></h2>
<p>Nous avons choisi de sponsoriser et d’assister à PGIBZ 2025 car nous croyons qu’il est important de promouvoir la communauté PostgreSQL dans le monde. Quoi qu’il en soit, c’est un événement qui cherche à améliorer l’éducation autour de Postgres. Les bénéfices de l’événement sont utilisés par l’organisation parente à but non lucratif, PostgreSQL España, pour financer la traduction de la documentation officielle PostgreSQL en espagnol.</p>
<p>Des approfondissements détaillés sur chacun des sujets de présentation mentionnés ci-dessus sont en cours ; n’hésitez pas à nous suivre sur <a href="https://www.linkedin.com/company/91744288/" rel="noopener">LinkedIn</a> et <a href="https://fosstodon.org/@data_bene" rel="noopener">Mastodon</a> pour les repérer quand ils seront publiés sur notre blog.</p>
<p>Nous avons beaucoup apprécié notre temps passé à PGIBZ 2025, et sommes honorés d’avoir eu l’opportunité de présenter et de participer. Hâte de revenir l’année prochaine !</p>
<h2 id="references"><a class="heading-anchor" href="#references">Références</a></h2>
<ul class="list">
<li><a href="https://ibiza.travel/en/know-ibiza/where-we-are/" rel="noopener">https://ibiza.travel/en/know-ibiza/where-we-are/</a></li>
<li><a href="https://pgibz.io/" rel="noopener">https://pgibz.io/</a></li>
<li><a href="https://whc.unesco.org/en/list/417" rel="noopener">https://whc.unesco.org/en/list/417</a></li>
<li><a href="https://www.hoteltrestorresibiza.com/" rel="noopener">https://www.hoteltrestorresibiza.com/</a></li>
</ul>
 ]]></content>
			<author>
				<name>Evan Stanton</name>
			</author>
    </entry>
    <entry>
      <title>Le saviez-vous ? Les tables dans PostgreSQL sont limitées à 1600 colonnes</title>
      <link href="https://www.data-bene.io/fr/blog/le-saviez-vous-les-tables-dans-postgresql-sont-limitees-a-1600-colonnes/" />
      <updated>2025-11-13T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/le-saviez-vous-les-tables-dans-postgresql-sont-limitees-a-1600-colonnes/</id>
     <content type="html"><![CDATA[ <p><strong>Saviez-vous qu’une table ne peut pas contenir plus de 1 600 colonnes ?</strong> Cet article de blog est inspiré d’une conversation avec Pierre Ducroquet.</p>
<h2 id="tout-dabord-la-documentation"><a class="heading-anchor" href="#tout-dabord-la-documentation">Tout d’abord, la documentation</a></h2>
<p><a href="https://www.postgresql.org/docs/current/limits.html" rel="noopener">L’annexe K</a> de la documentation PostgreSQL  indique qu’une table peut contenir jusqu’à 1 600 colonnes.</p>
<p>Il s’agit d’une <strong>limite codée en dur</strong>, visible dans le code source à l’adresse <code>src/include/access/htup_details.h</code> :</p>
<pre class="language-plaintext"><code class="language-plaintext">#define MaxTupleAttributeNumber 1664
#define MaxHeapAttributeNumber	1600</code></pre>
<h2 id="atteindre-la-limite-de-maniere-classique"><a class="heading-anchor" href="#atteindre-la-limite-de-maniere-classique">Atteindre la limite de manière classique</a></h2>
<p>Vérifions d’abord cette affirmation par quelques tests.</p>
<h3 id="jouer-avec-la-definition-de-la-table"><a class="heading-anchor" href="#jouer-avec-la-definition-de-la-table">Jouer avec la définition de la table</a></h3>
<p>Nous utilisons ici un script bash simple, facile à adapter aux différents tests.</p>
<pre class="language-sql"><code class="language-sql"><span class="token comment">-- Exemple classique</span>

<span class="token keyword">DO</span> $$
<span class="token keyword">DECLARE</span>
    i <span class="token keyword">int</span><span class="token punctuation">;</span>
<span class="token keyword">BEGIN</span>
    <span class="token keyword">EXECUTE</span> <span class="token string">'DROP TABLE IF EXISTS tint_1601;'</span><span class="token punctuation">;</span>
    <span class="token keyword">EXECUTE</span> <span class="token string">'CREATE TABLE tint_1601(i_1 int);'</span><span class="token punctuation">;</span>
    <span class="token keyword">FOR</span> i <span class="token operator">IN</span> <span class="token number">2.</span><span class="token number">.1601</span> <span class="token keyword">LOOP</span>
        <span class="token keyword">EXECUTE</span> <span class="token function">format</span><span class="token punctuation">(</span><span class="token string">'ALTER TABLE tint_1601 ADD COLUMN i_%s int;'</span><span class="token punctuation">,</span> i<span class="token punctuation">)</span><span class="token punctuation">;</span>
    <span class="token keyword">END</span> <span class="token keyword">LOOP</span><span class="token punctuation">;</span>
<span class="token keyword">END</span> $$<span class="token punctuation">;</span></code></pre>
<p>Le résultat est le suivant :</p>
<pre class="language-plaintext"><code class="language-plaintext">NOTICE:  table "tint_1600" does not exist, skipping
ERROR:  tables can have at most 1600 columns
CONTEXT:  SQL statement "ALTER TABLE tint_1600 ADD COLUMN i_1601 int;"
PL/pgSQL function inline_code_block line 8 at EXECUTE</code></pre>
<p>Jusqu’ici, tout va bien (ou du moins, tout fonctionne comme prévu).</p>
<p>Vous pourriez tenter de remplacer le type <code>int4</code> par le type <code>int2</code> pour arriver à créer une table de plus de 1 600 colonnes. Mais cela ne fonctionnera pas plus, car il s’agit d’une limite codée en dur.</p>
<h3 id="jouer-avec-le-contenu-dune-table"><a class="heading-anchor" href="#jouer-avec-le-contenu-dune-table">Jouer avec le contenu d’une table</a></h3>
<p>Générons une table de 1600 colonnes à partir du script sql précédent :</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">DO</span> $$
<span class="token keyword">DECLARE</span>
    i <span class="token keyword">int</span><span class="token punctuation">;</span>
<span class="token keyword">BEGIN</span>
    <span class="token keyword">EXECUTE</span> <span class="token string">'DROP TABLE IF EXISTS tint_1600;'</span><span class="token punctuation">;</span>
    <span class="token keyword">EXECUTE</span> <span class="token string">'CREATE TABLE tint_1600(i_1 int);'</span><span class="token punctuation">;</span>
    <span class="token keyword">FOR</span> i <span class="token operator">IN</span> <span class="token number">2.</span><span class="token number">.1600</span> <span class="token keyword">LOOP</span>
        <span class="token keyword">EXECUTE</span> <span class="token function">format</span><span class="token punctuation">(</span><span class="token string">'ALTER TABLE tint_1600 ADD COLUMN i_%s int;'</span><span class="token punctuation">,</span> i<span class="token punctuation">)</span><span class="token punctuation">;</span>
    <span class="token keyword">END</span> <span class="token keyword">LOOP</span><span class="token punctuation">;</span>
<span class="token keyword">END</span> $$<span class="token punctuation">;</span></code></pre>
<p>Construisons puis insérons un tuple de 1600 colonnes :</p>
<pre class="language-sql"><code class="language-sql"><span class="token keyword">DO</span> $$
<span class="token keyword">DECLARE</span>
    s <span class="token keyword">TEXT</span><span class="token punctuation">;</span>
    rows_inserted <span class="token keyword">int</span><span class="token punctuation">;</span>
<span class="token keyword">BEGIN</span>
    s :<span class="token operator">=</span> <span class="token function">format</span><span class="token punctuation">(</span>
                 <span class="token string">'INSERT INTO tint_1600 VALUES (1%s);'</span>
               <span class="token punctuation">,</span> <span class="token keyword">repeat</span><span class="token punctuation">(</span> <span class="token string">',1'</span> <span class="token punctuation">,</span> <span class="token number">1599</span> <span class="token punctuation">)</span>
               <span class="token punctuation">)</span><span class="token punctuation">;</span>
    <span class="token keyword">EXECUTE</span> s<span class="token punctuation">;</span>

    GET DIAGNOSTICS rows_inserted <span class="token operator">=</span> ROW_COUNT<span class="token punctuation">;</span>
    RAISE NOTICE <span class="token string">'Rows inserted: %'</span><span class="token punctuation">,</span> rows_inserted<span class="token punctuation">;</span>
<span class="token keyword">END</span> $$<span class="token punctuation">;</span></code></pre>
<p>The output is:</p>
<pre class="language-plaintext"><code class="language-plaintext">NOTICE:  Rows inserted: 1
DO</code></pre>
<p>Sans surprise, c’est encore un succès.</p>
<h3 id="trop-gros-pour-echouer"><a class="heading-anchor" href="#trop-gros-pour-echouer">Trop gros pour échouer ?</a></h3>
<p>Continuons à repousser les limites.</p>
<p>On créé maintenant une autre table de 1 600 colonnes, cette fois avec le type de données <code>char(127)</code>.</p>
<p>On réutilise notre script bash avec quelques modifications :</p>
<pre class="language-sql"><code class="language-sql"><span class="token comment">-- Create a table with 1,600 columns: 1 x int + 1599 x char(127)</span>
<span class="token keyword">DO</span> $$
<span class="token keyword">DECLARE</span>
    i <span class="token keyword">int</span><span class="token punctuation">;</span>
<span class="token keyword">BEGIN</span>
    <span class="token keyword">EXECUTE</span> <span class="token string">'DROP TABLE IF EXISTS tint_1600;'</span><span class="token punctuation">;</span>
    <span class="token keyword">EXECUTE</span> <span class="token string">'CREATE TABLE tint_1600(i_1 int);'</span><span class="token punctuation">;</span>
    <span class="token keyword">FOR</span> i <span class="token operator">IN</span> <span class="token number">2.</span><span class="token number">.1600</span> <span class="token keyword">LOOP</span>
        <span class="token keyword">EXECUTE</span> <span class="token function">format</span><span class="token punctuation">(</span><span class="token string">'ALTER TABLE tint_1600 ADD COLUMN c_%s char(127) NOT NULL;'</span><span class="token punctuation">,</span> i<span class="token punctuation">)</span><span class="token punctuation">;</span>
    <span class="token keyword">END</span> <span class="token keyword">LOOP</span><span class="token punctuation">;</span>
<span class="token keyword">END</span> $$<span class="token punctuation">;</span>

<span class="token comment">-- Insert a tuple - 1 x int + 1599 x char(127)</span>
<span class="token keyword">DO</span> $$
<span class="token keyword">DECLARE</span>
    s <span class="token keyword">TEXT</span><span class="token punctuation">;</span>
<span class="token keyword">BEGIN</span>
    s :<span class="token operator">=</span> <span class="token function">format</span><span class="token punctuation">(</span>
                 <span class="token string">'INSERT INTO tint_1600 VALUES (1%s);'</span>
               <span class="token punctuation">,</span> <span class="token keyword">repeat</span><span class="token punctuation">(</span> $q$<span class="token punctuation">,</span><span class="token string">'1'</span>::<span class="token keyword">char</span><span class="token punctuation">(</span><span class="token number">127</span><span class="token punctuation">)</span>$q$ <span class="token punctuation">,</span> <span class="token number">1599</span> <span class="token punctuation">)</span>
               <span class="token punctuation">)</span><span class="token punctuation">;</span>
    <span class="token keyword">EXECUTE</span> s<span class="token punctuation">;</span>
<span class="token keyword">END</span> $$<span class="token punctuation">;</span><span class="token identifier"><span class="token punctuation">`</span><span class="token punctuation">`</span></span><span class="token punctuation">`</span>

Le résultat est :</code></pre>
<p>ERROR:  row is too big: size 25616, maximum size 8160</p>
<pre class="language-plaintext"><code class="language-plaintext">
Comme on peut le voir, la table comporte effectivement 1 600 colonnes, mais cette fois, le tuple ne peut pas tenir dans une seule page heap, ce qui explique l'erreur « row is too big: size 25616, maximum size 8160 ». Si vous avez fait attention au script, vous avez pu constater que les colonnes sont définies comme `NOT NULL`. Aussi, lors de la création de la table, PostgreSQL aurait pu se rendre compte que l'insertion de données serait impossible. Mais il n'y a pas eu d'alerte.

## Quid des JOINs ?

Pour simplifier, testons avec une jointure automatique :

```sql
SELECT a.*,b.* FROM tint_1600 a, tint_1600 b;
ERROR:  target lists can have at most 1664 entries</code></pre>
<p>Maintenant, c’est la clause <code>SELECT</code> de (<code>a.*,b.*</code>) qui a atteint sa propre limite (<code>MaxTupleAttributeNumber = 1664</code>).</p>
<h2 id="atteindre-la-limite-de-colonnes-de-maniere-inattendue"><a class="heading-anchor" href="#atteindre-la-limite-de-colonnes-de-maniere-inattendue">Atteindre la limite de colonnes de manière inattendue</a></h2>
<p>Il arrive que vous deviez modifier votre application, et que cela entraîne des modifications de schéma.<br>
La plupart du temps, il s’agit de modifications de tables, comme l’ajout ou la suppression de colonnes.</p>
<h3 id="explorer-add-/-drop-column"><a class="heading-anchor" href="#explorer-add-/-drop-column">Explorer <code>ADD</code> / <code>DROP COLUMN</code></a></h3>
<p>Voyons ce qui se passe côté SQL lorsque nous ajoutons, puis supprimons, une colonne.</p>
<pre class="language-sql"><code class="language-sql"><span class="token operator">=</span><span class="token comment"># CREATE TABLE tadc_1600(i_1 int NOT NULL);</span>

<span class="token keyword">CREATE</span> <span class="token keyword">TABLE</span>

<span class="token operator">=</span><span class="token comment"># ALTER TABLE tadc_1600 ADD COLUMN i_2 int NOT NULL;</span>

<span class="token keyword">ALTER</span> <span class="token keyword">TABLE</span>

<span class="token operator">=</span><span class="token comment"># SELECT attname,attnum,attstorage,attnotnull,attisdropped</span>
   <span class="token keyword">FROM</span> pg_attribute
   <span class="token keyword">WHERE</span> attrelid<span class="token operator">=</span><span class="token punctuation">(</span>
                   <span class="token keyword">SELECT</span> oid
                   <span class="token keyword">FROM</span> pg_class
                   <span class="token keyword">WHERE</span> relname<span class="token operator">=</span><span class="token string">'tadc_1600'</span>
                   <span class="token punctuation">)</span>
     <span class="token operator">AND</span> attnum <span class="token operator">></span> <span class="token number">0</span> <span class="token keyword">ORDER</span> <span class="token keyword">BY</span> attnum<span class="token punctuation">;</span>

 attname <span class="token operator">|</span> attnum <span class="token operator">|</span> attstorage <span class="token operator">|</span> attnotnull <span class="token operator">|</span> attisdropped
<span class="token comment">---------+--------+------------+------------+--------------</span>
 i_1     <span class="token operator">|</span>      <span class="token number">1</span> <span class="token operator">|</span> p          <span class="token operator">|</span> t          <span class="token operator">|</span> f
 i_2     <span class="token operator">|</span>      <span class="token number">2</span> <span class="token operator">|</span> p          <span class="token operator">|</span> t          <span class="token operator">|</span> f
<span class="token punctuation">(</span><span class="token number">2</span> <span class="token keyword">rows</span><span class="token punctuation">)</span>

<span class="token operator">=</span><span class="token comment"># ALTER TABLE tadc_1600 DROP COLUMN i_2;</span>

<span class="token keyword">ALTER</span> <span class="token keyword">TABLE</span>

<span class="token operator">=</span><span class="token comment"># SELECT attname,attnum,attstorage,attnotnull,attisdropped</span>
   <span class="token keyword">FROM</span> pg_attribute
   <span class="token keyword">WHERE</span> attrelid<span class="token operator">=</span><span class="token punctuation">(</span>
                   <span class="token keyword">SELECT</span> oid
                   <span class="token keyword">FROM</span> pg_class
                   <span class="token keyword">WHERE</span> relname<span class="token operator">=</span><span class="token string">'tadc_1600'</span>
                   <span class="token punctuation">)</span>
     <span class="token operator">AND</span> attnum <span class="token operator">></span> <span class="token number">0</span> <span class="token keyword">ORDER</span> <span class="token keyword">BY</span> attnum<span class="token punctuation">;</span>

           attname            <span class="token operator">|</span> attnum <span class="token operator">|</span> attstorage <span class="token operator">|</span> attnotnull <span class="token operator">|</span> attisdropped
<span class="token comment">------------------------------+--------+------------+------------+--------------</span>
 i_1                          <span class="token operator">|</span>      <span class="token number">1</span> <span class="token operator">|</span> p          <span class="token operator">|</span> t          <span class="token operator">|</span> f
 <span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>pg<span class="token punctuation">.</span>dropped<span class="token punctuation">.</span><span class="token number">2.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span> <span class="token operator">|</span>      <span class="token number">2</span> <span class="token operator">|</span> p          <span class="token operator">|</span> f          <span class="token operator">|</span> t
<span class="token punctuation">(</span><span class="token number">2</span> <span class="token keyword">rows</span><span class="token punctuation">)</span></code></pre>
<p>Lors de la suppression d’une colonne, cette colonne</p>
<ul class="list">
<li>est renommée en « . » + « pg.dropped.» + attnum + « . »,</li>
<li>devient NULLable,</li>
<li>est marquée comme supprimée.</li>
</ul>
<h3 id="iterer-sur-lajout/la-suppression-de-colonnes"><a class="heading-anchor" href="#iterer-sur-lajout/la-suppression-de-colonnes">Itérer sur l’ajout/la suppression de colonnes</a></h3>
<p>On peut se demander s’il existe une limite au nombre d’opérations d’ajout/suppression qui peuvent être exécutées sur une table donnée.</p>
<p>Comme d’habitude, testons :</p>
<pre class="language-sql"><code class="language-sql"><span class="token comment">-- ADD / DROP COLUMN example</span>
<span class="token keyword">DO</span> $$
<span class="token keyword">DECLARE</span>
    i <span class="token keyword">int</span><span class="token punctuation">;</span>
<span class="token keyword">BEGIN</span>
    <span class="token keyword">EXECUTE</span> <span class="token string">'DROP TABLE IF EXISTS tadc;'</span><span class="token punctuation">;</span>
    <span class="token keyword">EXECUTE</span> <span class="token string">'CREATE TABLE tadc(i_1 int);'</span><span class="token punctuation">;</span>
    <span class="token keyword">FOR</span> i <span class="token operator">IN</span> <span class="token number">2.</span><span class="token number">.1601</span> <span class="token keyword">LOOP</span>
        <span class="token keyword">EXECUTE</span> <span class="token function">format</span><span class="token punctuation">(</span><span class="token string">'ALTER TABLE tadc ADD COLUMN i_%s int;'</span><span class="token punctuation">,</span> i<span class="token punctuation">)</span><span class="token punctuation">;</span>
        <span class="token keyword">EXECUTE</span> <span class="token function">format</span><span class="token punctuation">(</span><span class="token string">'ALTER TABLE tadc DROP COLUMN i_%s;'</span><span class="token punctuation">,</span> i<span class="token punctuation">)</span><span class="token punctuation">;</span>
    <span class="token keyword">END</span> <span class="token keyword">LOOP</span><span class="token punctuation">;</span>
<span class="token keyword">END</span> $$<span class="token punctuation">;</span></code></pre>
<p>Le résultat est :</p>
<pre class="language-plaintext"><code class="language-plaintext">ERROR:  tables can have at most 1600 columns
CONTEXT:  SQL statement "ALTER TABLE tadc ADD COLUMN i_1601 int;"
PL/pgSQL function inline_code_block line 8 at EXECUTE</code></pre>
<p>Oh oh ! On a atteint la limite des 1 600 ici aussi !</p>
<p>Explorons un peu ce qui se passe :</p>
<pre class="language-sql"><code class="language-sql"><span class="token operator">=</span><span class="token comment"># SELECT attname,attnum,attstorage,attnotnull,attisdropped</span>
   <span class="token keyword">FROM</span> pg_attribute
   <span class="token keyword">WHERE</span> attrelid<span class="token operator">=</span><span class="token punctuation">(</span>
                   <span class="token keyword">SELECT</span> oid
                   <span class="token keyword">FROM</span> pg_class
                   <span class="token keyword">WHERE</span> relname<span class="token operator">=</span><span class="token string">'tadc'</span>
                   <span class="token punctuation">)</span>
     <span class="token operator">AND</span> attnum <span class="token operator">></span> <span class="token number">0</span> <span class="token keyword">ORDER</span> <span class="token keyword">BY</span> attnum<span class="token punctuation">;</span>

             attname             <span class="token operator">|</span> attnum <span class="token operator">|</span> attstorage <span class="token operator">|</span> attnotnull <span class="token operator">|</span> attisdropped
<span class="token comment">---------------------------------+--------+------------+------------+--------------</span>
 i_1                             <span class="token operator">|</span>      <span class="token number">1</span> <span class="token operator">|</span> p          <span class="token operator">|</span> t          <span class="token operator">|</span> f
 <span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>pg<span class="token punctuation">.</span>dropped<span class="token punctuation">.</span><span class="token number">2.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>    <span class="token operator">|</span>      <span class="token number">2</span> <span class="token operator">|</span> p          <span class="token operator">|</span> f          <span class="token operator">|</span> t
 <span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>pg<span class="token punctuation">.</span>dropped<span class="token punctuation">.</span><span class="token number">3.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>    <span class="token operator">|</span>      <span class="token number">3</span> <span class="token operator">|</span> p          <span class="token operator">|</span> f          <span class="token operator">|</span> t
 <span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>pg<span class="token punctuation">.</span>dropped<span class="token punctuation">.</span><span class="token number">4.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>    <span class="token operator">|</span>      <span class="token number">4</span> <span class="token operator">|</span> p          <span class="token operator">|</span> f          <span class="token operator">|</span> t
 <span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>pg<span class="token punctuation">.</span>dropped<span class="token punctuation">.</span><span class="token number">5.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>    <span class="token operator">|</span>      <span class="token number">5</span> <span class="token operator">|</span> p          <span class="token operator">|</span> f          <span class="token operator">|</span> t

 <span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>pg<span class="token punctuation">.</span>dropped<span class="token punctuation">.</span><span class="token number">1599.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span> <span class="token operator">|</span>   <span class="token number">1599</span> <span class="token operator">|</span> p          <span class="token operator">|</span> f          <span class="token operator">|</span> t
 <span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span>pg<span class="token punctuation">.</span>dropped<span class="token punctuation">.</span><span class="token number">1600.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span><span class="token punctuation">.</span> <span class="token operator">|</span>   <span class="token number">1600</span> <span class="token operator">|</span> p          <span class="token operator">|</span> f          <span class="token operator">|</span> t
<span class="token punctuation">(</span><span class="token number">1600</span> <span class="token keyword">rows</span><span class="token punctuation">)</span></code></pre>
<p>La table <code>tadc</code> comporte 1 600 colonnes. Vous pouvez vous en apercevoir car toutes les modifications sont ajoutées à la table, et son contenu n’est pas réécrit.</p>
<p>Aussi, à ce stade, toute modification supplémentaire visant à ajouter ou supprimer des colonnes sera vouée à l’échec.</p>
<p>Comment faire pour me sortir de cette situation ?</p>
<h4 id="le-chevalier-du-vacuum-devrait-sauver-la-princesse-postgresql-non"><a class="heading-anchor" href="#le-chevalier-du-vacuum-devrait-sauver-la-princesse-postgresql-non">Le chevalier du VACUUM devrait sauver la princesse PostgreSQL, non ?</a></h4>
<p>Et non ! La commande <code>VACUUM</code> fonctionne au niveau du tuple, donc même si vous exécutez un <code>VACUUM FULL</code>, la structure de la table ne changera pas.</p>
<h4 id="donc-le-dragon-a-mange-le-chevalier-que-fait-on"><a class="heading-anchor" href="#donc-le-dragon-a-mange-le-chevalier-que-fait-on">Donc le dragon a mangé le chevalier, que fait-on ?</a></h4>
<p>Il ne s’agit pas d’un problème de tuples morts, mais plutôt d’un problème de catalogue.<br>
Vous devez créer une nouvelle définition de table.</p>
<p>Voici quelques solutions, des plus simples aux plus complexes :</p>
<ol class="list">
<li>
<p>Créer une nouvelle table avec interruption de service</p>
<ul class="list">
<li><code>CREATE TABLE LIKE (INCLUDING ALL)</code></li>
<li>Copier (<code>COPY</code>) les données de l’ancienne table vers la nouvelle</li>
<li>Renommer les tables</li>
<li>Supprimer l’ancienne table</li>
</ul>
</li>
<li>
<p>Exploiter la réplication logique pour minimiser les interruptions de service</p>
<ul class="list">
<li><code>CREATE TABLE LIKE (INCLUDING ALL)</code></li>
<li><code>CREATE local PUBLICATION/SUBSCRIPTION</code></li>
<li>Une fois les données synchronisées, arrêter/mettre en pause le service applicatif</li>
<li>Supprimer l’abonnement</li>
<li>Renommer les tables</li>
<li>Redémarrer/relancer l’application</li>
<li>Supprimer l’ancienne table</li>
</ul>
</li>
</ol>
<h2 id="contactez-nous"><a class="heading-anchor" href="#contactez-nous">Contactez-nous</a></h2>
<p>Vous avez d’autres idées pour résoudre ce problème ? Vous avez trouvé d’autres moyens étranges de déclencher cette erreur liée à la limite codée en dur ? <a href="https://www.data-bene.io/en/#contact" rel="noopener">Contactez-nous</a> ! Nous sommes toujours ravis d’échanger sur PostgreSQL.</p>
 ]]></content>
			<author>
				<name>Frédéric Delacourt</name>
			</author>
    </entry>
    <entry>
      <title>Retour de HOW2025</title>
      <link href="https://www.data-bene.io/fr/blog/retour-de-how2025/" />
      <updated>2025-07-14T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/retour-de-how2025/</id>
     <content type="html"><![CDATA[ <p>Les 27 et 28 juin se tenaient les conférences Highgo Open World, consacrées à l’écosystème PostgreSQL et au projet IvorySQL. Côté chiffres, le succès est notable : près de 1 000 participants sur place, jusqu’à 8 000 connexions simultanées sur les streams, et environ 25 000 spectateurs au total.</p>
<p>Le programme comptait 101 conférences techniques animées par 105 intervenants. La majorité des sessions étaient en mandarin, avec un track anglophone proposé en traduction simultanée. Vous pouvez consulter le programme complet sur <a href="https://ivorysql.io/schedule/" rel="noopener">IvorySQL.io</a> et retrouver les replays sur Weibo via <a href="https://ivorysql.io/2025/06/27/live-access-june27/" rel="noopener">ce lien.</a></p>
<p>Nous étions un petit groupe de la communauté internationale présents, dont <a href="https://postgresql.life/post/grant_zhou/" rel="noopener">Grant Zhou</a> qui assure entre autre la liaison et la collaboration avec l’association PostgreSQL en Chine et dans le reste du monde.</p>
<p>Sur le plan technique, le contenu était dense et particulièrement intéressant. J’ai retenu notamment :</p>
<ul class="list">
<li>
<p>La présentation d’Alena Rybakina sur le planificateur de requêtes PostgreSQL et les stratégies pour contourner certaines limites.</p>
</li>
<li>
<p>Un focus clair et concret sur Patroni (Haute-Disponibilité) par Alexander Kukushkin et Polina Bungina.</p>
</li>
<li>
<p>Florentz Tselai a présenté 2 sujets en appliquant ses préceptes: simplicité efficacité, sur l’utilisation de «l’IA» avec PostgreSQL et la gestion des données avec comme support Sun Tzu et les 36 stratagèmes.</p>
</li>
<li>
<p>Également une très bonne introduction à Bazel et son utilisation pour Monogres (à découvrir bientôt) présenté avec énergie par Alvaro Hernandez.</p>
<p>Monogres est une initiative très intéressante qui doit permettre de renforcer le contrôle de la supply chain logicielle, un thème  majeur dans l’IT de nos jours. Et j’y ai aussi vu une très belle occasion d’offrir une vitrine a des variations de PostgreSQL avec des fonctionnalités et des correctifs dont l’inclusion dans PostgreSQL lui-même même ou le backport dans des version majeures précédentes n’est pas toujours possible.</p>
</li>
<li>
<p>Michael Meskes avait l’honneur d’une conférence plénière pour un sujet qui le mérite largement: « From Code to Commerce: Open Source Business Models Today », une keynote sur l’open-source et les logiciels libres, appliqués à l’écosystème PostgreSQL.</p>
</li>
<li>
<p>Mon collègue Andrea a présenté les évolutions et les tendances des entreprises pour transiter vers IvorySQL et PostgreSQL</p>
</li>
<li>
<p>Pour ma part, j’ai présenté linux PSI dans le contexte PostgreSQL.</p>
</li>
</ul>
<p>Comme tout est en streaming, je vous encourage à aller explorer et visionner les sujets qui vous intéressent. Il y a ausi des conférences en anglais pré-enregistrées mais j’avoue avoir profité des créneaux pour échanger avec des participants.</p>
<p>En apparté des conférences, j’ai eu la chance de rencontrer plusieurs membres de la communauté PostgreSQL chinoise très réputés pour leur implication dans le succès de PostgreSQL localement. J’ai eu aussi l’occasion d’en apprendre d’avantage sur Cloudberry, en remplacement de Greenplum, merci Dianjin Wang!</p>
<hr>
<p>Pour Data Bene s’était également un moment prévu pour rencontrer l’équipe en charge d’IvorySQL, basée en grande partie dans le Shandong, la province où se trouve Jinan, ville hôte des conférences. Ivory est un projet auquel nous participons activement et qui permet aux entreprises de s’affranchir d’Oracle «en douceur». C’est un sujet important pour nos clients et qui occupe un place prépondérante dans notre partenariat avec Highgo: ils portent ce projet depuis plusieurs années déjà et nous voulons permettre aux entreprises européenes d’en profiter avec un accompagnement et expertise adaptée.</p>
<hr>
<p>Les conférences étaient très bien organisées et l’acceuil formidable, le «Social Event» au «beer garden» local parfaitement adapté à la chaleur de Jinan fin juin!</p>
<p>Vu le programme des conférences j’ai amèrement regreté de ne rien comprendre (Il y avait 1 track en Anglais et 5 en Mandarin) … mais il se dit déjà que l’an prochain les conférences en Mandarin pourraient peut être être traduites (en anglais), et la date avancée en Mai pour profiter d’un climat plus doux.</p>
<p>Il y a tellement à y apprendre que j’y retournerai avec grand plaisir.</p>
 ]]></content>
			<author>
				<name>Cédric Villemain</name>
			</author>
    </entry>
    <entry>
      <title>SCaLE 22x : réunir la communauté open source à Pasadena</title>
      <link href="https://www.data-bene.io/fr/blog/scale-22x-r%C3%A9unir-la-communaut%C3%A9-open-source-%C3%A0-pasadena/" />
      <updated>2025-06-02T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/scale-22x-r%C3%A9unir-la-communaut%C3%A9-open-source-%C3%A0-pasadena/</id>
     <content type="html"><![CDATA[ <p>Le Southern California Linux Expo (SCaLE) 22x, reconnu comme la plus grande conférence d’Amérique du Nord gérée par la communauté et axée sur l’open source et le logiciel libre, s’est tenu au Pasadena Convention Center du 6 au 9 mars 2025. <em>Quand je dis géré par la communauté, je le pense vraiment — pas de patrons corporatifs dictant l’agenda, juste un pur enthousiasme open source qui anime quatre jours de discussions techniques et de collaboration.</em></p>
<p>La conférence de cette année s’est centrée sur les thèmes de l’IA, du DevOps et des technologies cloud-native, de l’engagement de la communauté open source, de la sécurité et de la conformité, des systèmes et de l’infrastructure, ainsi que du FOSS @ home (explorer le monde des applications auto-hébergées et des services cloud).</p>
<p>La conférence a attiré des participants venus du monde entier pour tout discuter autour de l’open source, le Linux au cœur bien sûr, tout en poursuivant la discussion sur des sujets tels que les systèmes embarqués et l’IoT. Comme toujours, un mélange unique de discussions technologiques de pointe et de résolution pratique de problèmes dans chaque espace est ce qui rend SCaLE spécial.</p>
<h2 id="conduire-les-elephants-postgresql@scale22x"><a class="heading-anchor" href="#conduire-les-elephants-postgresql@scale22x"><strong>Conduire les éléphants : PostgreSQL@SCaLE22x</strong></a></h2>
<p>PostgreSQL@SCaLE22x s’est déroulé comme un événement dédié de deux jours et deux sessions, les 6 et 7 mars 2025, reconnu dans le cadre des directives des événements communautaires du PostgreSQL Global Development Group. L’équipe de sélection comprenait Gabrielle Roth, Joe Conway et Mark Wong, garantissant la qualité qu’on attend de la communauté PostgreSQL.</p>
<p>La liste des intervenants était impressionnante : Magnus Hagander, Christophe Pettus, Peter Farkas, Devrim Gündüz, Hamid Akhtar, Henrietta Dombrovskaya, Shaun Thomas, Gülçin Yıldırım Jelínek &amp; Andrew Farries, Nick Meyer et Jimmy Angelakos. Une session particulièrement mémorable s’intitulait “Row-Level Security Sucks. Can We Make It Usable ?” — une prise de position honnête et rafraîchissante sur la fonctionnalité RLS de PostgreSQL qui a probablement résonné auprès de plus d’un administrateur de base de données dans le public.</p>
<p>Le panel communautaire “Posez-nous vos questions” a été animé par Stacey Haysler et a compté Christophe Pettus, Devrim Gündüz, Jimmy Angelakos, Magnus Hagander et Mark Wong. C’est lors de ces sessions que le véritable transfert de connaissances a lieu — pas de discours marketing, juste des praticiens discutant entre pairs des mécanismes internes de PostgreSQL, des performances, des bonnes pratiques et de l’avenir de la base de données.</p>
<p>Dans les coulisses, les bénévoles Derya Gumustel, Erika Miller, Hamid Akhtar, Jennifer Scheuerell, Mark Wong et Roberto Mello ont tout fait fonctionner sans accroc, PGUS ayant assuré le stand dans le hall d’exposition.</p>
<p>Personnellement, j’ai eu le plaisir de collaborer avec Jimmy Angelakos lors de ses <a href="https://vyruss.org/blog/scale-22x-live-streams-row-level-security-sucks.html" rel="noopener">sessions de streaming en direct</a> avec d’autres invités comme Henrietta Dombrovskaya, Mark Wong, Gülçin Yıldırım Jelínek, et même une brève apparition de Devrim Gündüz.</p>
<p><em>L’un des sujets discutés avec Gülçin Yıldırım Jelínek dans le podcast est de savoir s’il y a un intérêt communautaire pour poursuivre <a href="https://www.youtube.com/watch?v=WwaJd2c9whM" rel="noopener">Postgres Café</a>. Qu’en pensez-vous ? Souhaitez-vous voir plus d’épisodes de cette série de podcast, élargissant les discussions sur les extensions et le développement open source au reste de la communauté et au-delà ? Dites-le nous : <a href="mailto:contact@data-bene.io">contact@data-bene.io</a></em></p>
<h2 id="quelque-chose-pour-tout-le-monde"><a class="heading-anchor" href="#quelque-chose-pour-tout-le-monde"><strong>Quelque chose pour tout le monde</strong></a></h2>
<p>Il y a beaucoup d’événements colocalisés en plus de PostgreSQL @ SCaLE, dont “SCaLE : The Next Generation (TNG)”, un événement technologique axé sur la jeunesse encourageant des activités interactives et des présentations pour les étudiants, ainsi que le concours annuel Cybersecurity Capture the Flag (CTF) présenté par Cal Poly FAST et Pacific Hackers.</p>
<p>SCaLE reste un excellent endroit pour réseauter en vue d’avancer dans sa carrière dans l’open source. Se mêler aux stands est toujours un excellent moyen de faire des connexions et de trouver des opportunités, bien sûr, mais la journée Open Source Career Day est également revenue afin d’offrir un espace dédié aux professionnels et aux technologistes en herbe pour qu’ils puissent puiser dans des ressources, des outils, des exemples concrets et un contenu engageant issus des présentations et des ateliers.</p>
<p>L’amusante tradition de tenir une soirée jeux le samedi avec nourriture et boissons s’est également poursuivie cette année, avec un Trivia Night (présenté par Uncoded) et d’autres activités amusantes comme le lancer de hache gonflable, la cible Nerf, les arts et l’artisanat, une salle de jeux de société, une soirée casino et une salle de blocs pour construire des “derby cars” , jouer au pictionary ou construire avec de gros blocs.</p>
<h2 id="gardez-votre-calendrier-libre-pour-scale-23x"><a class="heading-anchor" href="#gardez-votre-calendrier-libre-pour-scale-23x"><strong>Gardez votre calendrier libre pour SCaLE 23x</strong></a></h2>
<p>SCaLE s’est imposé comme une présence constante à Pasadena, et cette stabilité a permis à la conférence de bâtir des relations durables avec la communauté locale et les lieux. Restez à l’affût des annonces de SCaLE 23x — la visite promet d’en valoir la peine.</p>
<p>Pour ceux qui s’intéressent plus spécifiquement à PostgreSQL@SCaLE, restez attentifs aux listes de diffusion PostgreSQL pour les annonces concernant les opportunités de bénévolat, d’intervention ou d’autres moyens de participer à l’événement de l’année prochaine. Le parcours et le stand PostgreSQL sont une source constante de discussions engageantes parmi ceux de la communauté Postgres et au-delà, reflétant l’adoption croissante de la base de données dans l’industrie.</p>
<h2 id="le-rassemblement-open-source-pour-tous"><a class="heading-anchor" href="#le-rassemblement-open-source-pour-tous"><strong>Le rassemblement open source pour tous</strong></a></h2>
<p>Dans un monde où de nombreuses conférences technologiques ressemblent davantage à des vitrines élaborées pour vendeurs, SCaLE reste ce rassemblement rare où la communauté passe en premier, la collaboration est authentique, et les discussions technologiques sont portées par des praticiens qui résolvent de vrais problèmes. Notez bien SCaLE 23x dans votre calendrier — c’est une conférence qui tient toujours sa promesse de rassembler les enthousiastes de l’open source pour collaborer et apprendre réellement.</p>
<p>Vous regrettez de ne pas y avoir été ? Vous pouvez toujours consulter <a href="https://www.youtube.com/playlist?list=PLh1QjGnfC2eREVHe8shz8Db7jGJvZerCK" rel="noopener">la playlist YouTube des interventions</a> qui ont été enregistrées lors de la conférence, pour bénéficier au moins du savoir qu’elles contiennent.</p>
 ]]></content>
			<author>
				<name>Sarah Conway</name>
			</author>
    </entry>
    <entry>
      <title>Postgres Café : Contribuer à l'Open Source</title>
      <link href="https://www.data-bene.io/fr/blog/postgres-cafe-contribuer-a-l-open-source/" />
      <updated>2025-03-04T00:00:00Z</updated>
      <id>https://www.data-bene.io/fr/blog/postgres-cafe-contribuer-a-l-open-source/</id>
     <content type="html"><![CDATA[ <p>C’est notre sixième épisode de <a href="https://www.youtube.com/watch?v=WwaJd2c9whM" rel="noopener">Café Postgres</a>, un podcast collaboratif de <a href="https://www.data-bene.io/en/" rel="noopener">Data Bene</a> &amp; <a href="https://xata.io/" rel="noopener">Xata</a> où nous discutons de tout, des extensions PostgreSQL aux contributions de la communauté. Dans l’épisode d’aujourd’hui, Sarah Conway et Gülçin Yıldırım Jelinek recontrent Andrea Cucciniello pour discuter de la manière dont les entreprises et les particuliers peuvent contribuer aux projets open source, et des raisons pour lesquelles ils pourraient envisager de le faire.</p>
<h2 id="episode-6-developpement-dextensions-postgresql-la-communaute-et-au-dela"><a class="heading-anchor" href="#episode-6-developpement-dextensions-postgresql-la-communaute-et-au-dela">Épisode 6 : Développement d’extensions PostgreSQL, la communauté et au-delà</a></h2>
<p>À quelle fréquence les entreprises expriment-elles leur intérêt pour une contribution open source ? Il est évident que toute aide apportée profite directement aux projets open source. Mais y a-t-il des avantages pour l’entreprise qui contribue ? Quels sont les modes de contribution qu’une entreprise peut envisager ? Ce sont des questions que nous entendons souvent. Explorons donc certaines des réponses évoquées dans cet épisode à travers un bref récapitulatif.</p>
<h3 id="contribuer-aux-projets-et-aux-communautes-open-source"><a class="heading-anchor" href="#contribuer-aux-projets-et-aux-communautes-open-source">Contribuer aux projets et aux communautés open source</a></h3>
<p>Chez Data Bene, nous avons déjà quelques clients intéressés par le développement de fonctionnalités ou d’améliorations pour l’écosystème PostgreSQL.</p>
<p>Ces entreprises souhaitent corriger des bugs et ajouter de nouvelles fonctionnalités qui complètent leurs cas d’utilisation et leurs piles technologiques dans PostgreSQL, Citus Data et les technologies associées pour accomplir deux choses :</p>
<ol class="list">
<li>Pour créer les fonctionnalités dont ils ont besoin, qui sont nativement intégrées au logiciel en amont et maintenues de manière transparente par la grande communauté open source, et</li>
<li>Pour garantir que d’autres personnes ayant un cas d’utilisation similaire puissent également tirer parti de ces avantages.</li>
</ol>
<p>Les temps changent ; la seule façon pour le logiciel source de rester pertinent, utile et bénéfique pour le public mondial qui l’utilise est de bénéficier de contributions mondiales, garantissant qu’il répond toujours aux besoins réels des utilisateurs d’année en année.</p>
<h3 id="pourquoi-soutenir-des-projets-open-source"><a class="heading-anchor" href="#pourquoi-soutenir-des-projets-open-source">Pourquoi soutenir des projets open source ?</a></h3>
<p>La dépendance vis-à-vis des fournisseurs est un problème majeur dans le secteur des logiciels et des services ; contribuer aux projets open source garantit que la technologie ouvertement développée peut continuer à l’être. L’utilisation de la technologie FOSS signifie que vous évitez d’investir dans une entreprise qui pourrait fermer le code ou en restreindre l’accès, donnant ainsi à l’utilisateur final la liberté de continuer à utiliser et à développer des outils essentiels qui font partie de sa pile technologique.</p>
<p>Ce type de logiciel est également soumis à un processus de développement très visible, ce qui signifie qu’il est beaucoup plus difficile d’intégrer dans le code sous-jacent des atteintes à la vie privée, des vulnérabilités de cybersécurité, etc.</p>
<p>De plus, les logiciels open source sont créés par des individus du monde entier ayant des perspectives et des parcours variés ; cela garantit qu’ils sont minutieusement testés, et intègrent un large éventail de fonctionnalités intégrées qui sont <em>réellement utiles</em> à de nombreux utilisateurs finaux. Cela permet à ce type de projets d’être couronnés de succès pendant de nombreuses années, aussi longtemps qu’il existe une communauté prête à les soutenir.</p>
<p><em>Exemple concret : PostgreSQL existe depuis plus de 35 ans de développement actif et figure toujours aujourd’hui en tête des enquêtes et des classements des développeurs comme étant la solution de base de données la plus appréciée, la plus utilisée et la plus populaire au monde !</em></p>
<h3 id="comment-les-entreprises-peuvent-elles-soutenir-au-mieux-les-projets-open-source"><a class="heading-anchor" href="#comment-les-entreprises-peuvent-elles-soutenir-au-mieux-les-projets-open-source">Comment les entreprises peuvent-elles soutenir au mieux les projets open source ?</a></h3>
<p>Il existe quelques moyens clés pour atteindre cet objectif final :</p>
<ol class="list">
<li><strong>Incluez les contributions de code au temps de travail de vos ingénieurs.</strong> Lorsque vous allouez du temps aux développeurs pour travailler sur le code en amont, vous vous assurez que la technologie que vous exploitez (pour fournir un support et/ou des services, pour alimenter votre produit ou sur laquelle repose votre infrastructure) bénéficie de performances améliorées, de fonctionnalités étendues, de problèmes résolus ou de corrections de bugs.</li>
<li><strong>Envisagez de développer des extensions.</strong> La création et la maintenance d’extensions permettent aux entreprises d’ajouter des fonctionnalités spécialisées ou de répondre à certains cas d’utilisation sans altérer la base de code principale. Dans le cas de PostgreSQL en particulier, cette extensibilité permet à Postgres de répondre aux besoins de différents secteurs, utilisateurs et entreprises, avec un écosystème polyvalent et solide. Ce type de système modulaire permet à PostgreSQL d’évoluer sans complexifier trop son noyau, ce qui rend le projet dans son ensemble plus facile à gérer et à mettre à jour.</li>
<li><strong>Sponsorisez, organisez et participez à des événements.</strong> En tant qu’entreprise, vous pouvez choisir de promouvoir ou d’initier des conférences technologiques, des groupes d’utilisateurs, des ateliers et bien plus encore pour sensibiliser et éduquer le grand public sur la technologie que vous souhaitez voir prospérer. Les événements sont un excellent moyen pour les utilisateurs et les développeurs de collaborer, de discuter des avancées et de partager les meilleures pratiques, ce qui renforce la communauté et améliore le produit en conséquence.</li>
</ol>
<h3 id="comment-data-bene-contribue"><a class="heading-anchor" href="#comment-data-bene-contribue">Comment Data Bene contribue</a></h3>
<p>Cédric Villemain, président de Data Bene, a développé <a href="https://codeberg.org/c2main/pgfincore" rel="noopener">pg_fincore</a> et travaille actuellement sur <a href="https://codeberg.org/data-bene/statsmgr" rel="noopener">StatsMgr</a>, pg_psi et d’autres composants conçus pour améliorer les capacités statistiques de Postgres.</p>
<p>Notre équipe est également responsable d’un certain nombre de contributions dans le cadre de projets tels que <a href="https://www.citusdata.com/blog/2025/02/06/distribute-postgresql-17-with-citus-13/" rel="noopener">Citus Data</a> et <a href="https://github.com/zammad/zammad/" rel="noopener">Zammad</a>.</p>
<p>Nous nous efforçons de sponsoriser, de présenter et de promouvoir des conférences et des groupes d’utilisateurs de la communauté PostgreSQL ou open source, tels que PostgreSQL Europe, pgDay Paris, AlpOSS, Capitole du Libre, et bien d’autres. Certains membres de notre équipe ont également initié ou font partie des comités d’organisation de divers événements tels que les groupes d’utilisateurs PostgreSQL de Barcelone et de Madrid et pgDay Lowlands. L’impact des événements sur le projet et la communauté dans son ensemble ne peut être sous-estimé, et il est important pour nous d’y contribuer de cette manière.</p>
<p>Enfin, nous aidons les clients à comprendre comment contribuer à PostgreSQL et à des projets open source similaires. Par le biais de formations, d’ateliers et de collaborations, nous les encourageons à apporter des contributions significatives qui correspondent à leurs objectifs et soutiennent la communauté dans son ensemble.</p>
<p><em>Si vous êtes un développeur souhaitant contribuer à l’écosystème open source et/ou PostgreSQL, ou aider les clients avec leurs besoins en R&amp;D, notre équipe s’agrandit : rendez-nous visite sur notre <a href="https://data-bene.io/en/jobs" rel="noopener">site web</a> pour voir les postes disponibles!</em></p>
<h3 id="regardez-lepisode-complet"><a class="heading-anchor" href="#regardez-lepisode-complet">Regardez l’épisode complet</a></h3>
<p>Vous souhaitez regarder la discussion dans son intégralité ? Elle est disponible sur YouTube (en anglais uniquement) :</p>
<iframe width="560" height="315" src="https://www.youtube-nocookie.com/embed/BYvXQB9O71U?si=-irKIHXxwiPhBFQP" title="YouTube video player" frameborder="0" allow="accelerometer; autoplay; clipboard-write; encrypted-media; gyroscope; picture-in-picture; web-share" referrerpolicy="strict-origin-when-cross-origin" allowfullscreen></iframe>
<h3 id="restez-a-lecoute-pour-plus-doutils-postgres"><a class="heading-anchor" href="#restez-a-lecoute-pour-plus-doutils-postgres">Restez à l’écoute pour plus d’outils Postgres</a></h3>
<p>A ce jour, nous avons terminé notre première série d’épisodes pour Postgres Café ! D’autres épisodes pourraient suivre, ou pas. Suivez-nous sur les réseaux sociaux (comme <a href="https://www.linkedin.com/company/91744288" rel="noopener">LinkedIn</a> ou <a href="https://fosstodon.org/@data_bene" rel="noopener">Mastodon</a>) pour être informé des prochaines sorties. (Voulez-vous en savoir plus sur cette série de podcasts ? Faites-le nous savoir !)</p>
<p><a href="https://www.youtube.com/playlist?list=PLf7KS0svgDP_zJmby3RMzzOVO45qLbruA" rel="noopener">Abonnez-vous à la playlist</a> ou consultez-le pour des interviews sur les extensions open source comme <a href="https://codeberg.org/Data-Bene/StatsMgr" rel="noopener">StatsMgr</a> pour une gestion efficace des statistiques de PostgreSQL, ou <a href="https://youtu.be/j1R3a0-jg6c" rel="noopener">pgstream</a>, un outil open source de capture de données modifiées (CDC) conçu spécifiquement pour PostgreSQL ou bien d’autres. PostgreSQL est l’une des bases de données les plus extensibles du marché avec un vaste écosystème d’extensions ; apprenez directement des experts en découvrant certaines des options disponibles.</p>
 ]]></content>
			<author>
				<name>Sarah Conway</name>
			</author>
    </entry>
</feed>