Qu’est-ce qu’un graphe ?
Un graphe est un ensemble d’éléments et un ensemble de connexions entre ces éléments. La définition est simple!
Les éléments sont appelés sommets (ou nœuds) et les connexions sont appelées arêtes (ou relations).
Formellement, un graphe $G $ est modélisé comme un couple $(V, E)$, où $V $ est un ensemble de sommets et $e $ est un sous-ensemble du produit cartésien de $V $ par lui-même, représentant un ensemble d’arêtes :
$E \subseteq V \times V$
On distingue trois types de graphes : orientés, non orientés et pondérés.
-
Pour un graphe orienté, une arête $e $ est le couple ordonné $(u, v)$ dans $e $, où $u $ est le sommet source et $V $ est le sommet destination; un exemple est l’abonnement sur Twitter, où la relation a une direction spécifique :
arête $e = (u, v) \in E$ -
Pour un graphe non orienté, une arête $e $ est un couple non ordonné contenant $u $ et $V $ dans $e $ ; un exemple est l’amitié sur Facebook, où la relation est mutuelle :
arête $e = { u, v } \in E$ -
Un graphe pondéré étend cette structure en un triplet $(V, E, w)$, où $w$ est une fonction qui associe à chaque arête dans $e $ un nombre réel (un poids), utile pour représenter des distances, des coûts ou des forces :
triplet $(V, E, w)$ où $w: E \to \mathbb{R}$
Où sont les graphes ?
La puissance du modèle graphe réside dans son universalité. Dès qu’on commence à chercher, les graphes sont partout.
- Les réseaux sociaux représentent l’amitié, les abonnements et les interactions comme des arêtes connectant des sommets utilisateurs.
Savoir si Alice connaît Bob par l’intermédiaire d’autres personnes
est essentiellement un parcours du graphe pour trouver cette relation.
-
Les systèmes de détection de fraude modélisent les transactions bancaires entre comptes sous forme de graphes. Les activités frauduleuses génèrent des structures particulières très faciles à repérer telles des cycles ou des amas denses de relations transactions-comptes.
Les relations entre entités révèlent souvent la fraude plus fiablement que les entités elles-mêmes. -
Les chaînes d’approvisionnement et la logistique utilisent les graphes pour modéliser les dépendances entre fournisseurs, entrepôts et expéditions.
-
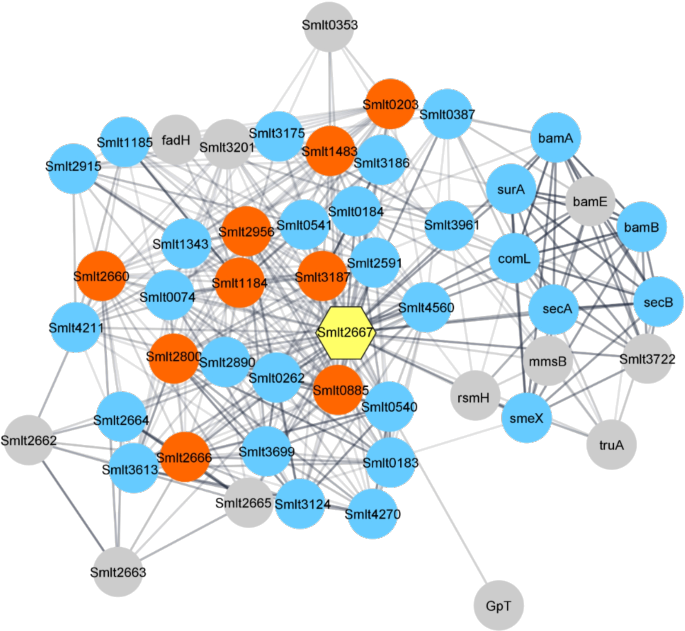
Les biologistes représentent les réseaux d’interaction protéique et les relations médicament-cible.
-
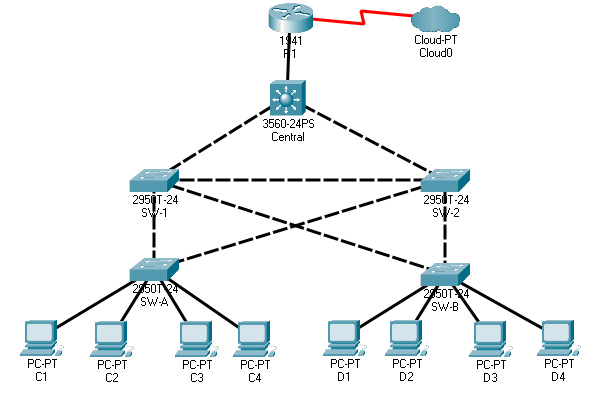
Les réseaux informatiques utilisent les graphes pour représenter les topologies.
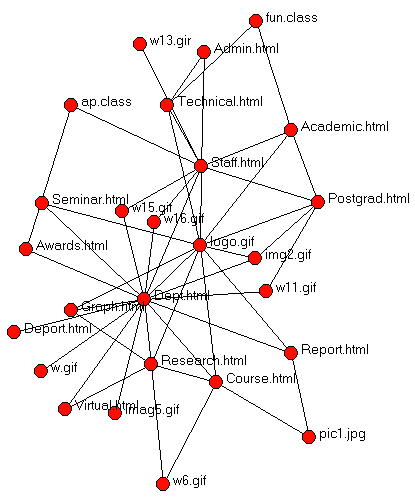
- Le Web est un autre exemple de graphe.
Les pages sont des sommets, les hyperliens sont des arêtes orientées, et le graphe résultant est l’une des structures les plus vastes et les plus étudiées en informatique :
Modéliser comme un graphe
Ce que partagent les exemples de domaines ci-dessus sont des propriétés qui font du graphe une solution intuitive pour nous, êtres humains. Les relations sont aussi importantes que les entités elles-mêmes.
Le schéma est souvent irrégulier ou évolutif. Les requêtes suivent fréquemment des chaînes de connexions dont la longueur ou la forme n’est pas connue à l’avance.
Les graphes sont également efficaces parce qu’ils sont faciles à raisonner visuellement. Les êtres humains comprennent mieux les choses avec des exemples, et un graphe rend les relations explicites. Cette clarté visuelle et structurelle se traduit souvent par des modèles de données et des algorithmes plus faciles à expliquer et à questionner.
Le modèle défini au début de cet article, un ensemble de sommets et un ensemble d’arêtes sans donnée attachée, sous-tend une grande partie de la théorie classique des graphes et constitue la base des frameworks de traitement de graphes et des systèmes de gestion de bases de données graphe. Il est toutefois trop limité pour la plupart des scénarios de bases de données réels, car il ne transporte aucune information au-delà de la structure. Les modèles plus riches utilisés dans les bases de données graphe sont construits sur cette base.
- Le Labeled Property Graph (LPG) est le modèle conceptuel standard utilisé par la plupart des systèmes de bases de données graphe. Il enrichit le graphe simple par deux mécanismes : les labels, qui classent les sommets et les arêtes en types, et les propriétés, qui attachent des données arbitraires de type clé-valeur aux sommets et aux arêtes individuels.
Un sommet pourrait avoir le labelPersonet les propriétésname='Alice'etage=21.
Une arête pourrait avoir le labelKNOWSet la propriétésince = "09.08.2007".
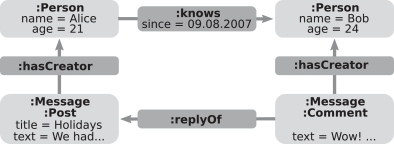
D’autres variantes du LPG sont implémentées par d’autres systèmes avec de légères extensions ou restrictions ; par exemple, Neo4j prend en charge un nombre arbitraire de labels par sommet mais limite les arêtes à exactement un label.
- Le Resource Description Framework (RDF) adopte une approche différente. Le RDF représente l’information comme des collections de triplets sujet, prédicat, objet $(s, p, o)$.
Si les systèmes basés sur le RDF constituent une part significative du paysage des bases de données graphe, ils suivent un modèle de données différent du LPG et sont hors du cadre de cette série. Nous le mentionnons uniquement pour le contexte, cette série d’articles étant centrée sur les bases de données graphe de type “labeled property graph”.
Les nombreuses formes des bases de données graphe
Le paysage des bases de données graphe est hétérogène. Les systèmes diffèrent fondamentalement dans la manière dont ils stockent les graphes, les modèles de données qu’ils supportent et les langages de requête qu’ils exposent.
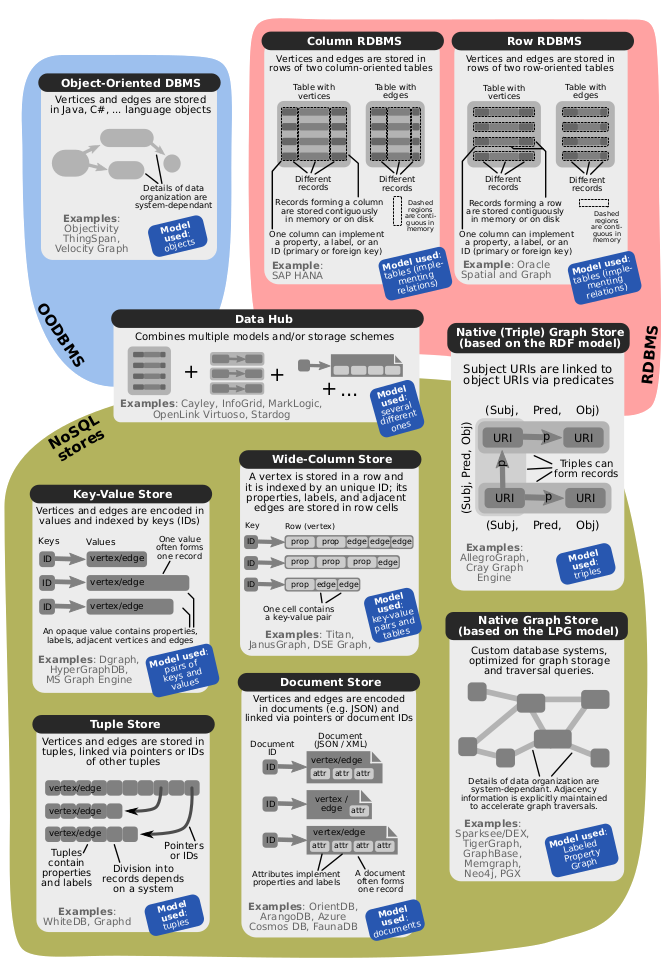
Les bases de données graphe natives sont conçues de A à Z autour du modèle graphe. Leurs schémas de stockage et leurs moteurs de requête sont pensés avec les schémas d’accès aux graphes comme préoccupation principale : elles visent à « suivre les pointeurs », ou à accéder à l’adjacence directement, de sorte que la navigation « ne devienne pas un JOIN ».
Neo4j en est l’exemple le plus marquant. Pendant longtemps, son moteur de stockage utilisait des enregistrements de taille fixe avec des pointeurs directs entre eux, et c’était essentiellement ainsi que les gens décrivaient le stockage graphe natif.
Après une quinzaine d’années, en 2024, Neo4j a introduit un format de blocs qui co-localise les données apparentées dans des blocs de longueur variable à l’intérieur de pages [1]. Bien que cette prise de conscience tardive soit un progrès, elle implique que la description « natif équivaut à suivre des pointeurs » n’est plus tout à fait exacte.
La définition utile devrait donc être comportementale, c’est-à-dire que les systèmes natifs tentent de rendre l’accès à l’adjacence direct, que ce soit par des pointeurs, des blocs co-localisés ou d’autres schémas spécifiques aux graphes.
Les bases de données graphe non natives reprennent un backend mature existant ; une base relationnelle, orientée document ou clé-valeur, et construisent des capacités graphe par-dessus [2]. Les deux classes sont des bases de données graphe au sens où elles stockent, interrogent et gèrent des données de type graphe, mais leurs composants internes sont fondamentalement différents, ce qui implique que des optimisations spécifiques aux graphes sont disponibles, adapatées au backend.
En pratique, la différence porte davantage sur l’endroit où l’effort d’ingénierie est investi : par exemple, les systèmes non natifs héritent de décennies de travail en contrôle de concurrence, indexation, optimisation des requêtes et bien d’autres composants de SGBD.
Une étude d’une centaine de systèmes de bases de données graphe révèle qu’environ 66 % sont non natifs. La répartition des modèles de données sous-jacents se décompose comme suit : 34 % de stockage graphe natif, 24 % de bases de données relationnelles, 24 % de stockages clé-valeur ou à colonnes larges, et 18 % de stockages orientés document. Cela a du sens : on souhaite rendre un SGBD existant capable de supporter les requêtes graphe si possible, offrant ainsi aux utilisateurs la meilleure interface possible.
C’est précisément à cet endroit que PostgreSQL entre en jeu. En tant que base de données relationnelle mature, elle représente une part massive de cet écosystème non natif à travers des extensions et de nouvelles normes SQL.
Points clés
Avant de passer à l’implémentation technique, rappelons les concepts fondamentaux de cette introduction :
- Les graphes sont universels : Au fond, ils ne sont que des sommets (nœuds) et des arêtes (relations), ce qui les rend idéaux pour des données complexes et interconnectées comme les réseaux sociaux ou les réseaux de fraude.
- Le LPG est la norme de l’industrie : Le modèle Labeled Property Graph étend les graphes simples en permettant d’attacher des labels et des propriétés clé-valeur aux nœuds et aux arêtes.
- Natif vs. non-natif est une distinction comportementale : Les bases de données natives (comme Neo4j) optimisent l’accès direct à l’adjacence, tandis que les bases non natives exploitent des moteurs de niveau entreprise existants (relationnels, orientés document) pour traiter les charges de travail graphe.
- Le paysage est hybride : Plus de 66 % des solutions de bases de données graphe sont construites sur des backends non graphe, prouvant qu’il n’est pas toujours nécessaire de déployer une nouvelle base de données native pour interroger des structures de type graphe.
Et maintenant ?
Maintenant que nous avons posé le vocabulaire de base, nous pouvons explorer comment intégrer ce modèle dans le monde relationnel. Dans la partie 1, nous plongerons directement dans SQL/PGQ dans PostgreSQL : ce que cette nouvelle norme apporte, comment elle est implémentée en interne, et les limitations actuelles.